


इन्फ्रास्ट्रक्चर, बिना रात के 3 बजे की ऑन-कॉल मुसीबत के।
ऑटोमेटेड डिप्लॉय, मॉनिटरिंग और सिक्योरिटी, ताकि हर रिलीज़ रोज़ का काम बन जाए।
सामग्री समीक्षा:
आपका इन्फ्रास्ट्रक्चर आपकी सबसे उबाऊ चीज़ होनी चाहिए।
इन्फ्रास्ट्रक्चर तभी नज़र आता है जब वह टूट जाता है — ट्रैफ़िक के चरम पर, डेमो के दौरान, रात के 3 बजे। कारण कभी विचित्र नहीं होते: हाथ से बदले गए सर्वर, ऐसे डिप्लॉय जो किसी एक व्यक्ति पर निर्भर हों, ऐसे अलर्ट जिन्हें कोई नहीं पढ़ता और ऐसे खर्च जिनका कोई जवाबदेह नहीं।
हम इसे जान-बूझकर उबाऊ बनाते हैं। सब कुछ कोड के रूप में, हर डिप्लॉय स्वचालित और प्रतिवर्ती, हर सिस्टम बेपटरी होने से पहले ही ऑब्ज़र्वेबल। हमने FeelEat के लिए पूरा DevOps DigitalOcean पर, Kubernetes और Docker के साथ बनाया, और LeadTrack AI के लिए AWS पर, Docker के साथ।
इस तरह डिज़ाइन किया गया कि सब निश्चिंत रहें।
एक प्रोडक्शन क्लाउड के छह स्तर, जो सबको चैन की नींद सोने देते हैं।
क्लाउड आर्किटेक्चर
AWS या DigitalOcean पर सही आकार के मल्टी-एनवायरनमेंट सेटअप, उस लोड के लिए डिज़ाइन किए गए जो आपके पास सच में है।
CI / CD
ऐसी पाइपलाइनें जो हर मर्ज पर टेस्ट, बिल्ड और रिलीज़ करती हैं — प्रगतिशील रोलआउट और एक-क्लिक रोलबैक के साथ।
सुरक्षा और मॉनिटरिंग
न्यूनतम-विशेषाधिकार IAM, सीक्रेट्स प्रबंधन, ऑडिट ट्रेल और ऐसे अलर्ट जो लोगों को तभी जगाएँ जब कोई व्यक्ति सचमुच मदद कर सके।
Infrastructure as Code
हर संसाधन के लिए Terraform — समीक्षायोग्य, पुनरुत्पादन योग्य और एक दोपहर में शून्य से फिर से बनाया जा सकने वाला।
ऑटो-स्केलिंग और लागत नियंत्रण
ऐसी क्षमता जो माँग का अनुसरण करे और बजट जिसका एक ज़िम्मेदार हो — परफ़ॉर्मेंस और बिल, दोनों नियंत्रण में।
इंसिडेंट रिस्पॉन्स
रनबुक, चौबीसों घंटे स्वचालित अलर्ट और बिना दोषारोपण वाले पोस्ट-मॉर्टम — ऑन-कॉल रोटा एक मैनेज्ड DevOps रिटेनर में उपलब्ध।
स्थिर करें, स्वचालित करें, भूल जाएँ।
एक माइग्रेशन पथ जो कभी भी आपकी उपलब्धता को किसी वीकेंड के स्विच-ओवर पर दाँव पर नहीं लगाता।
01ऑडिट करें और मैप करें
हर संसाधन, निर्भरता और single point of failure प्रलेखित — उन सब समेत जिन्हें सिर्फ़ एक इंजीनियर जानता था।
02सच्चाई को कोड में ढालें
मौजूदा इन्फ्रास्ट्रक्चर को Terraform में आयात किया जाता है। उस पल से बदलाव रिव्यू से गुज़रता है, SSH से नहीं।
03डिलीवरी को स्वचालित करें
टेस्ट, स्टेजिंग और रोलबैक के साथ CI/CD। डिप्लॉय डरावने आयोजनों से बदलकर रोज़मर्रा की मामूली बातें बन जाते हैं।
04देखें और मज़बूत करें
डैशबोर्ड, अलर्ट, लोड टेस्ट और सिक्योरिटी रिव्यू — फिर चाहें तो उसी टीम से निरंतर प्रबंधन।
अगला केस आपका प्रोडक्ट हो सकता है।
मुफ़्त 4 घंटे के वर्कशॉप से शुरुआत करेंएक फ़ूड-टेक ऑपरेशन के नीचे Kubernetes।
FeelEat के सॉफ़्टवेयर के पीछे का पूरा DevOps, DigitalOcean पर। LeadTrack AI के लिए हमने यही AWS पर किया।
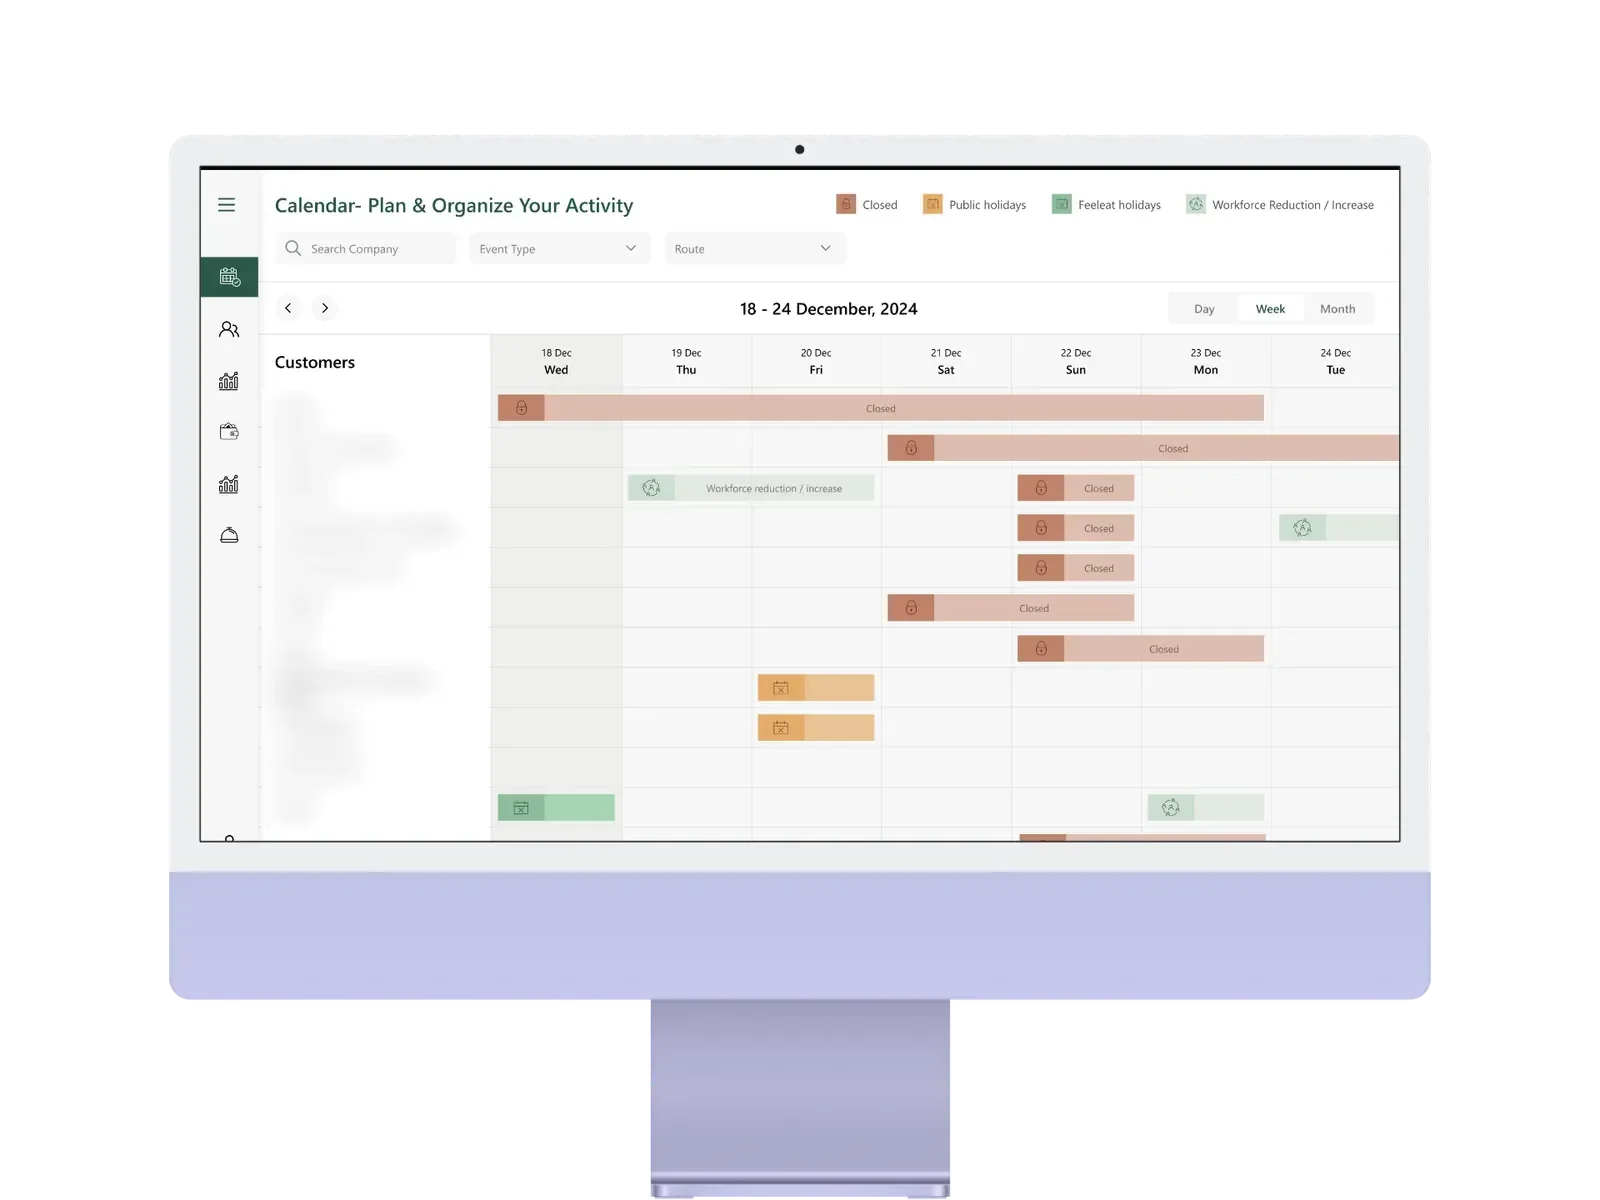
FeelEat
हमने FeelEat का DevOps DigitalOcean पर बनाया: सर्विसेज़ Docker कंटेनरों में पैक होकर Kubernetes पर चलती हैं। LeadTrack AI AWS पर चलता है, वह भी Docker में, और उसका DevOps भी इसी टीम ने बनाया।
समस्या के लिए चुने गए, CV के लिए नहीं।
AWS या DigitalOcean, Docker और Kubernetes, और सब कुछ स्वचालित: वह टूलचेन जिसे आपकी अगली भर्ती पहले से ही जानती है।
एक ही टीम। शून्य हैंडऑफ़।
DevOps और क्लाउड के साथ सबसे अधिक जोड़े जाने वाले अनुशासन — वही आर्किटेक्चर, वही इंजीनियर, कोई इंटीग्रेशन शुल्क नहीं।
सवाल, जवाब।
DevOps और क्लाउड के खरीदार हमसे सबसे अधिक क्या पूछते हैं। बाकी के लिए — इसे एक brief में बताएँ, एक सीनियर इंजीनियर एक कार्यदिवस के भीतर जवाब देता है।
इसे एक ब्रीफ़ में रखें। एक सीनियर इंजीनियर — कोई सेल्स प्रतिनिधि नहीं — एक कार्यदिवस के भीतर जवाब देता है।
क्या आप ऐसा इन्फ्रास्ट्रक्चर संभाल सकते हैं जिसे हम पहले से चला रहे हैं?
हाँ — यह सबसे आम काम है। हम ऑडिट करते हैं, सब कुछ Terraform में आयात करते हैं और कुछ भी बदलने से पहले उसे स्थिर करते हैं। कोई big-bang माइग्रेशन नहीं: आपकी उपलब्धता कभी दाँव पर नहीं लगती।
क्या इससे हमारा क्लाउड बिल कम होगा?
अक्सर हाँ, सही आकार देने, शेड्यूलिंग और स्टोरेज की साफ़-सफ़ाई से, लेकिन कोई आँकड़ा हम ऑडिट के बाद ही बताते हैं। सबसे ज़रूरी, लागतें दिखने लगती हैं और हर लागत का एक ज़िम्मेदार होता है, इसलिए बिल अब हर महीने का आश्चर्य नहीं रहता।
क्या हमें फिर भी अपनी आंतरिक DevOps भर्ती की ज़रूरत होगी?
ज़रूरी नहीं। हम आपके लिए पूरा संचालन कर सकते हैं, या प्लेटफ़ॉर्म बनाकर आपके अपने व्यक्ति को उस पर प्रशिक्षित कर सकते हैं। दोनों ही हालात में, कोड और क्लाउड अकाउंट आपके होते हैं, इसलिए कोई lock-in नहीं।
आप अनुपालन कैसे संभालते हैं — GDPR, SOC 2, ISO?
Infrastructure as code अनुपालन को प्रमाणित-योग्य बना देता है: ऑडिट ट्रेल, एक्सेस समीक्षाएँ और स्वचालित रूप से जनरेट किए गए प्रमाण।
क्या हमें Kubernetes की ज़रूरत है?
शायद नहीं। 50 से कम इंजीनियरों वाली अधिकांश टीमों के लिए एक मैनेज्ड PaaS (Vercel, Fly, Railway, ECS, Cloud Run) बेहतर रहता है। हम Kubernetes तब अपनाते हैं जब उसकी परिचालन जटिलता वास्तविक स्केल या अनुपालन आवश्यकताओं से न्यायसंगत हो।
और disaster recovery का क्या?
हम RTO/RPO लक्ष्यों को व्यावसायिक ज़रूरत के अनुसार डिज़ाइन करते हैं (वेंडरों की अधिकतमवादिता के अनुसार नहीं), परीक्षित रिस्टोर प्रक्रियाओं के साथ स्वचालित बैकअप लागू करते हैं, और जब आपके अनुपालन नियम माँगें, तो नियमित रिस्टोर अभ्यास भी करा सकते हैं।
अच्छी ऑब्ज़र्वेबिलिटी असल में कैसी होती है?
तीन स्तंभ इरादे के साथ बनाए गए: संरचित लॉग, मेट्रिक्स और वितरित ट्रेस, जो एक request ID से सहसंबंधित हों, और OpenTelemetry इन्स्ट्रुमेंटेशन परत के रूप में ताकि किसी एक वेंडर से बँधे न रहें। कसौटी: एक ऑन-कॉल इंजीनियर बिना किसी मशीन पर SSH किए मिनटों में एक अलर्ट से मूल कारण तक पहुँच सके। ऐसे डैशबोर्ड जिन्हें कोई नहीं देखता, ऑब्ज़र्वेबिलिटी नहीं हैं।
आप डिप्लॉय को इतना सुरक्षित कैसे बनाते हैं कि उन्हें दिन में कई बार किया जा सके?
Trunk-based development, मर्ज गेट के रूप में स्वचालित टेस्ट और प्रगतिशील डिलीवरी — canary या blue-green, जिसमें त्रुटि दर या लेटेंसी में गिरावट पर स्वचालित रोलबैक हो। Feature flags डिप्लॉय को रिलीज़ से अलग कर देते हैं, ताकि कोड रिलीज़ करना और उसे चालू करना अलग-अलग निर्णय बन जाएँ। कई छोटे और बार-बार किए गए डिप्लॉय, दुर्लभ बड़े डिप्लॉय से अधिक सुरक्षित होते हैं — जो अधिकांश टीमों की सहज समझ के बिलकुल उलट है।
कितने समय से आपने
बिना सांस रोके रिलीज़ नहीं किया?
हमें अपना स्टैक, अपने डिप्लॉय के दिन और अपना पिछला इंसिडेंट बताएँ। एक सीनियर इन्फ्रास्ट्रक्चर इंजीनियर एक कार्यदिवस के भीतर एक ईमानदार आकलन के साथ जवाब देता है।