


Infrastruktura bez pagera o 3 nad ranem.
Automatyczne wdrożenia, monitoring i bezpieczeństwo, dzięki którym wydania stają się rutyną.
Treść zweryfikowana:
Twoja infrastruktura powinna być najbardziej nudną rzeczą, jaką posiadasz.
Infrastrukturę zauważamy dopiero wtedy, gdy zawodzi — w szczycie ruchu, podczas demo, o 3 nad ranem. Przyczyny nigdy nie są egzotyczne: serwery edytowane ręcznie, wdrożenia zależne od jednej osoby, alerty, których nikt nie czyta, i koszty, za które nikt nie odpowiada.
My czynimy ją nudną z premedytacją. Wszystko jako kod, każde wdrożenie zautomatyzowane i odwracalne, każdy system obserwowalny, zanim wykolei się z torów. Zbudowaliśmy pełne DevOps dla FeelEat na DigitalOcean, z Kubernetesem i Dockerem, oraz dla LeadTrack AI na AWS, z Dockerem.
Zaprojektowane dla spokoju.
Sześć warstw chmury produkcyjnej, dzięki którym wszyscy mogą spać spokojnie.
Architektura chmurowa
Odpowiednio zwymiarowane środowiska na AWS lub DigitalOcean — zaprojektowane pod obciążenie, które naprawdę masz.
CI / CD
Potoki, które testują, budują i dostarczają przy każdym merge'u — z etapowymi rolloutami i rollbackiem jednym kliknięciem.
Bezpieczeństwo i nadzór
IAM oparte na zasadzie minimalnych uprawnień, zarządzanie sekretami, ścieżki audytu i alerty ustawione tak, by budzić ludzi tylko wtedy, gdy człowiek może pomóc.
Infrastructure as Code
Terraform dla każdego zasobu — możliwy do przeglądu, odtwarzalny i odbudowywalny od zera w jedno popołudnie.
Auto-skalowanie i kontrola kosztów
Pojemność, która podąża za popytem, i budżety z osobami odpowiedzialnymi — wydajność i rachunek jednocześnie pod kontrolą.
Reagowanie na incydenty
Runbooki, automatyczne alerty przez całą dobę i post-mortemy bez obwiniania — z dyżurami dostępnymi w ramach zarządzanego retainera DevOps.
Ustabilizować, zautomatyzować, zapomnieć.
Ścieżka migracji, która nigdy nie stawia Twojej dostępności na jednym weekendzie przełączenia.
01Audyt i mapowanie
Każdy zasób, każda zależność i każdy pojedynczy punkt awarii udokumentowane — także te, o których wiedział tylko jeden inżynier.
02Skodyfikować prawdę
Istniejąca infrastruktura zaimportowana do Terraform. Od tej chwili zmiana następuje przez przegląd, a nie przez SSH.
03Zautomatyzować dostarczanie
CI/CD z testami, stagingiem i rollbackiem. Wdrożenia przestają być budzącymi lęk wydarzeniami i stają się codziennymi nie-wydarzeniami.
04Obserwować i utwardzać
Dashboardy, alerty, testy obciążeniowe i przegląd bezpieczeństwa — a potem opcjonalne dalsze utrzymanie przez ten sam zespół.
Twój produkt może być kolejnym case na tej stronie.
Zacznij od bezpłatnego 4-godzinnego warsztatuKubernetes pod firmą food-tech.
Pełne DevOps za oprogramowaniem FeelEat, na DigitalOcean. Dla LeadTrack AI zrobiliśmy to samo na AWS.
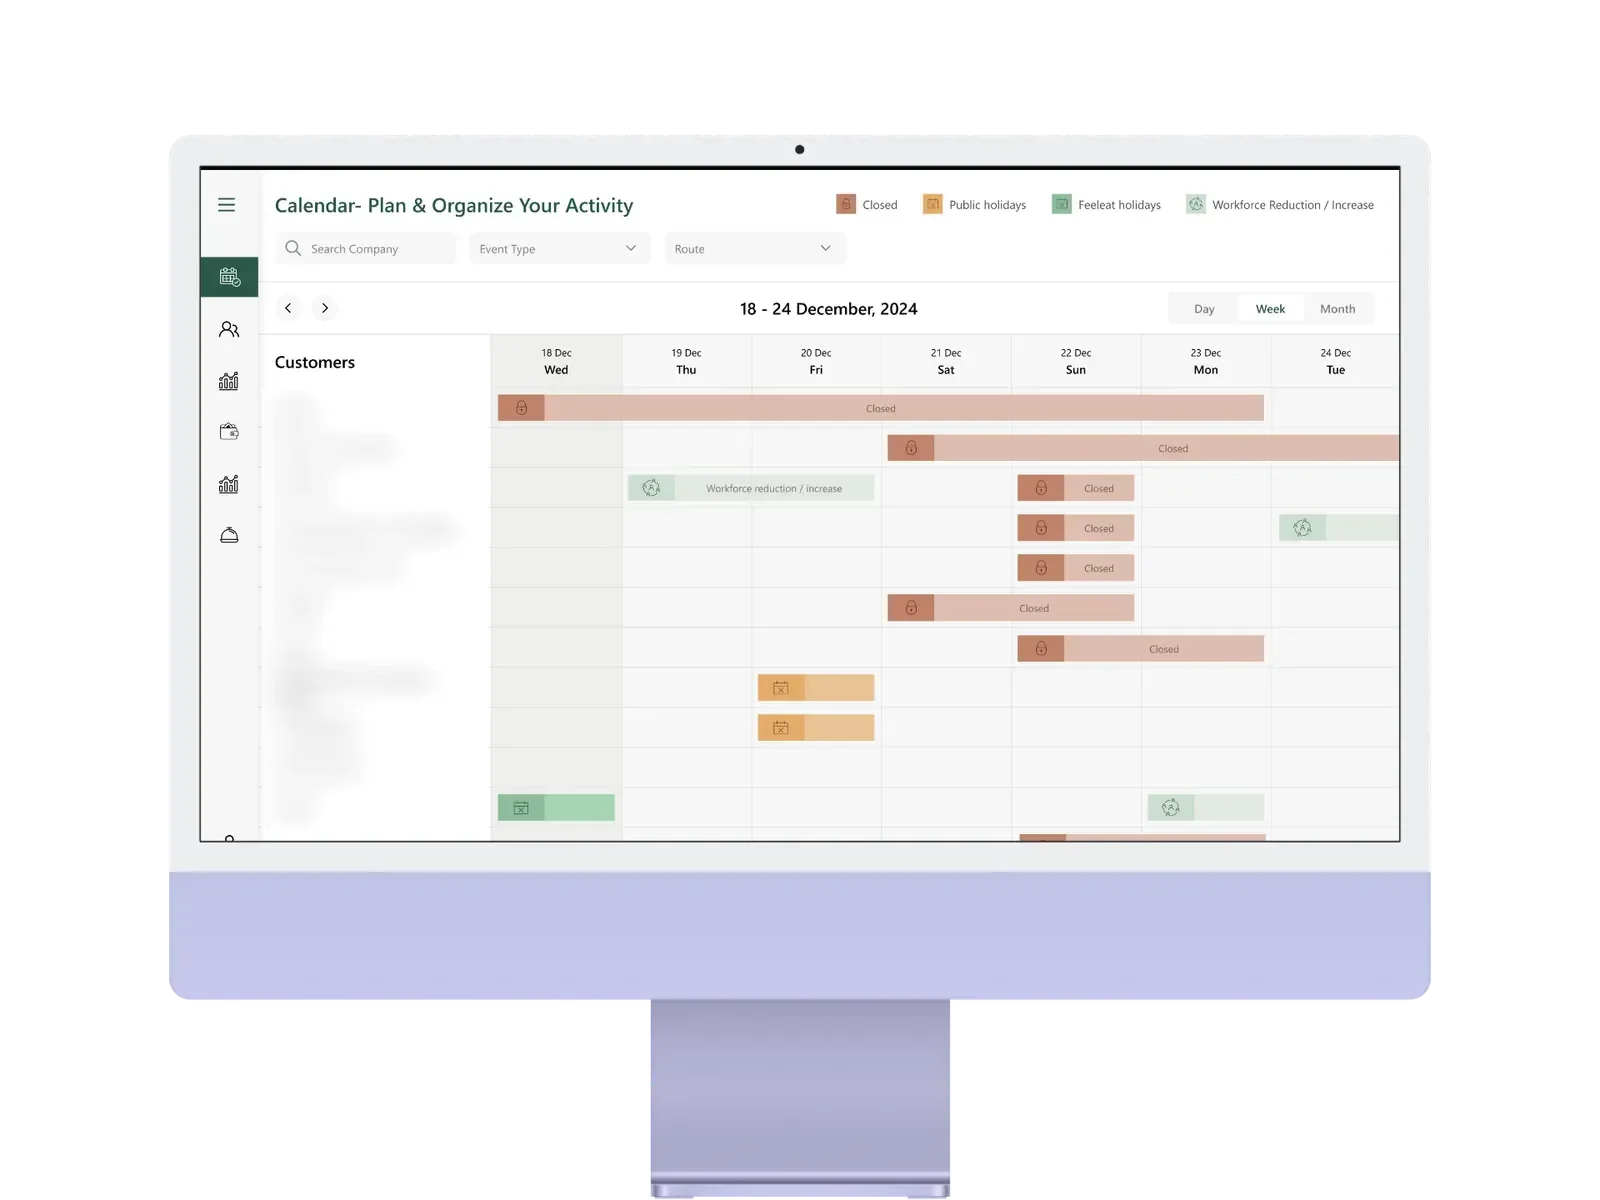
FeelEat
Zbudowaliśmy DevOps FeelEat na DigitalOcean: usługi spakowane w kontenery Docker i uruchamiane na Kubernetesie. LeadTrack AI działa na AWS, również w Dockerze, z DevOps od tego samego zespołu.
Wybrane pod problem, nie pod CV.
AWS lub DigitalOcean, Docker i Kubernetes, wszystko zautomatyzowane: łańcuch narzędzi, który Twój kolejny pracownik już zna.
Jeden zespół. Zero przekazań.
Dyscypliny najczęściej łączone z DevOps i chmurą — ta sama architektura, ci sami inżynierowie, bez podatku integracyjnego.
Pytania, odpowiedzi.
O co najczęściej pytają nas kupujący usługi DevOps i chmury. Resztę — opisz w briefie, inżynier senior odpowie w ciągu jednego dnia roboczego.
Opisz to w briefie. Odpowie doświadczony inżynier — nie handlowiec — w ciągu jednego dnia roboczego.
Czy możecie przejąć infrastrukturę, którą już eksploatujemy?
Tak — to najczęstszy rodzaj współpracy. Przeprowadzamy audyt, importujemy wszystko do Terraform i stabilizujemy, zanim cokolwiek zmienimy. Żadnej migracji typu big-bang: Twoja dostępność nigdy nie jest stawką w zakładzie.
Czy to obniży nasz rachunek za chmurę?
Często tak, dzięki odpowiedniemu wymiarowaniu, harmonogramowaniu i porządkom w magazynie danych, ale konkretną liczbę podajemy dopiero po audycie. Co ważniejsze, koszty stają się widoczne i przypisane: rachunek przestaje być comiesięczną niespodzianką.
Czy nadal potrzebujemy własnego pracownika DevOps?
Niekoniecznie. Możemy prowadzić eksploatację za Ciebie albo zbudować platformę i wdrożyć w nią Twojego własnego pracownika. W obu przypadkach kod i konta chmurowe należą do Ciebie, więc nie ma żadnego uzależnienia (lock-in).
Jak zarządzacie zgodnością — RODO, SOC 2, ISO?
Infrastruktura jako kod sprawia, że zgodność jest możliwa do wykazania: ścieżki audytu, przeglądy dostępu i dowody generowane automatycznie.
Czy potrzebujemy Kubernetesa?
Prawdopodobnie nie. Większość zespołów liczących mniej niż 50 inżynierów lepiej obsłuży zarządzany PaaS (Vercel, Fly, Railway, ECS, Cloud Run). Kubernetes wdrażamy wtedy, gdy jego złożoność operacyjną uzasadnia rzeczywista skala lub wymogi zgodności.
A co z odtwarzaniem po awarii (disaster recovery)?
Projektujemy cele RTO/RPO dopasowane do potrzeby biznesowej (a nie do maksymalizmu dostawcy), wdrażamy automatyczne kopie zapasowe z przetestowanymi procedurami odtwarzania i możemy regularnie przeprowadzać ćwiczenia odtwarzania, gdy wymagają tego Twoje zasady zgodności.
Jak naprawdę wygląda dobra obserwowalność?
Trzy filary realizowane z rozmysłem: ustrukturyzowane logi, metryki i rozproszone ślady (traces) skorelowane przez identyfikator żądania, z OpenTelemetry jako warstwą instrumentacji, by nie być uzależnionym od jednego dostawcy. Test jest taki: czy inżynier na dyżurze potrafi przejść od alertu do przyczyny źródłowej w kilka minut, bez logowania się przez SSH na maszynę. Dashboardy, na które nikt nie patrzy, to nie obserwowalność.
Jak sprawiacie, że wdrożenia są na tyle bezpieczne, by robić je kilka razy dziennie?
Rozwój oparty na trunku (trunk-based), automatyczne testy jako brama przed merge'em oraz progressive delivery — canary lub blue-green z automatycznym rollbackiem przy regresji wskaźnika błędów lub opóźnień. Feature flagi oddzielają wdrożenie od release'u, dzięki czemu dostarczenie kodu i jego włączenie to osobne decyzje. Częste małe wdrożenia są bezpieczniejsze niż rzadkie duże, co jest przeciwieństwem intuicji większości zespołów.
Kiedy ostatnio wdrażaliście
bez wstrzymywania oddechu?
Opowiedz nam o swoim stacku, dniach wdrożeń i ostatnim incydencie. Starszy inżynier infrastruktury odpowie w ciągu jednego dnia roboczego ze szczerą oceną.