


L'infrastruttura senza la reperibilità alle 3 di notte.
Deploy automatizzati, monitoraggio e sicurezza, perché i rilasci diventino routine.
Contenuto revisionato:
La tua infrastruttura dovrebbe essere la cosa più noiosa che possiedi.
L'infrastruttura si nota solo quando cede — al picco di traffico, durante la demo, alle 3 di notte. Le cause non sono mai esotiche: server modificati a mano, deploy che dipendono da una sola persona, alert che nessuno legge e costi di cui nessuno risponde.
La rendiamo noiosa di proposito. Tutto come codice, ogni deploy automatizzato e reversibile, ogni sistema osservabile prima che vada fuori strada. Abbiamo costruito tutto il DevOps di FeelEat su DigitalOcean, con Kubernetes e Docker, e quello di LeadTrack AI su AWS, con Docker.
Progettato per la calma.
I sei livelli di un cloud di produzione che lascia dormire tutti.
Architettura cloud
Ambienti multipli su AWS o DigitalOcean, dimensionati correttamente — pensati per il carico che hai davvero, non per uno schema di riferimento.
CI / CD
Pipeline che testano, costruiscono e rilasciano a ogni merge — con rollout progressivi e rollback in un clic.
Sicurezza & monitoraggio
IAM con privilegio minimo, gestione dei segreti, audit trail e alert tarati per svegliare le persone solo quando una persona può davvero aiutare.
Infrastructure as Code
Terraform per ogni risorsa — revisionabile, riproducibile e ricostruibile da zero in un pomeriggio.
Auto-scaling & controllo dei costi
Capacità che segue la domanda e budget con un responsabile — performance e fattura entrambe sotto controllo.
Risposta agli incidenti
Runbook, alert automatici 24 ore su 24 e post-mortem senza colpe — con la reperibilità disponibile in un retainer DevOps gestito.
Stabilizzare, automatizzare, dimenticare.
Un percorso di migrazione che non scommette mai la tua disponibilità su un weekend di switch-over.
01Auditare & mappare
Ogni risorsa, dipendenza e single point of failure documentato — compresi quelli che conosceva un solo ingegnere.
02Codificare la verità
L'infrastruttura esistente importata in Terraform. Da quel momento il cambiamento passa per la review, non per SSH.
03Automatizzare la delivery
CI/CD con test, staging e rollback. I deploy passano da eventi temuti a non-eventi, quotidiani.
04Osservare & irrobustire
Dashboard, alert, test di carico e security review — poi una gestione continuativa opzionale, a cura dello stesso team.
Il suo prodotto potrebbe essere il prossimo caso in questa pagina.
Inizi con un workshop gratuito di 4 oreKubernetes sotto un'attività food-tech.
Tutto il DevOps dietro il software di FeelEat, su DigitalOcean. Per LeadTrack AI abbiamo fatto lo stesso su AWS.
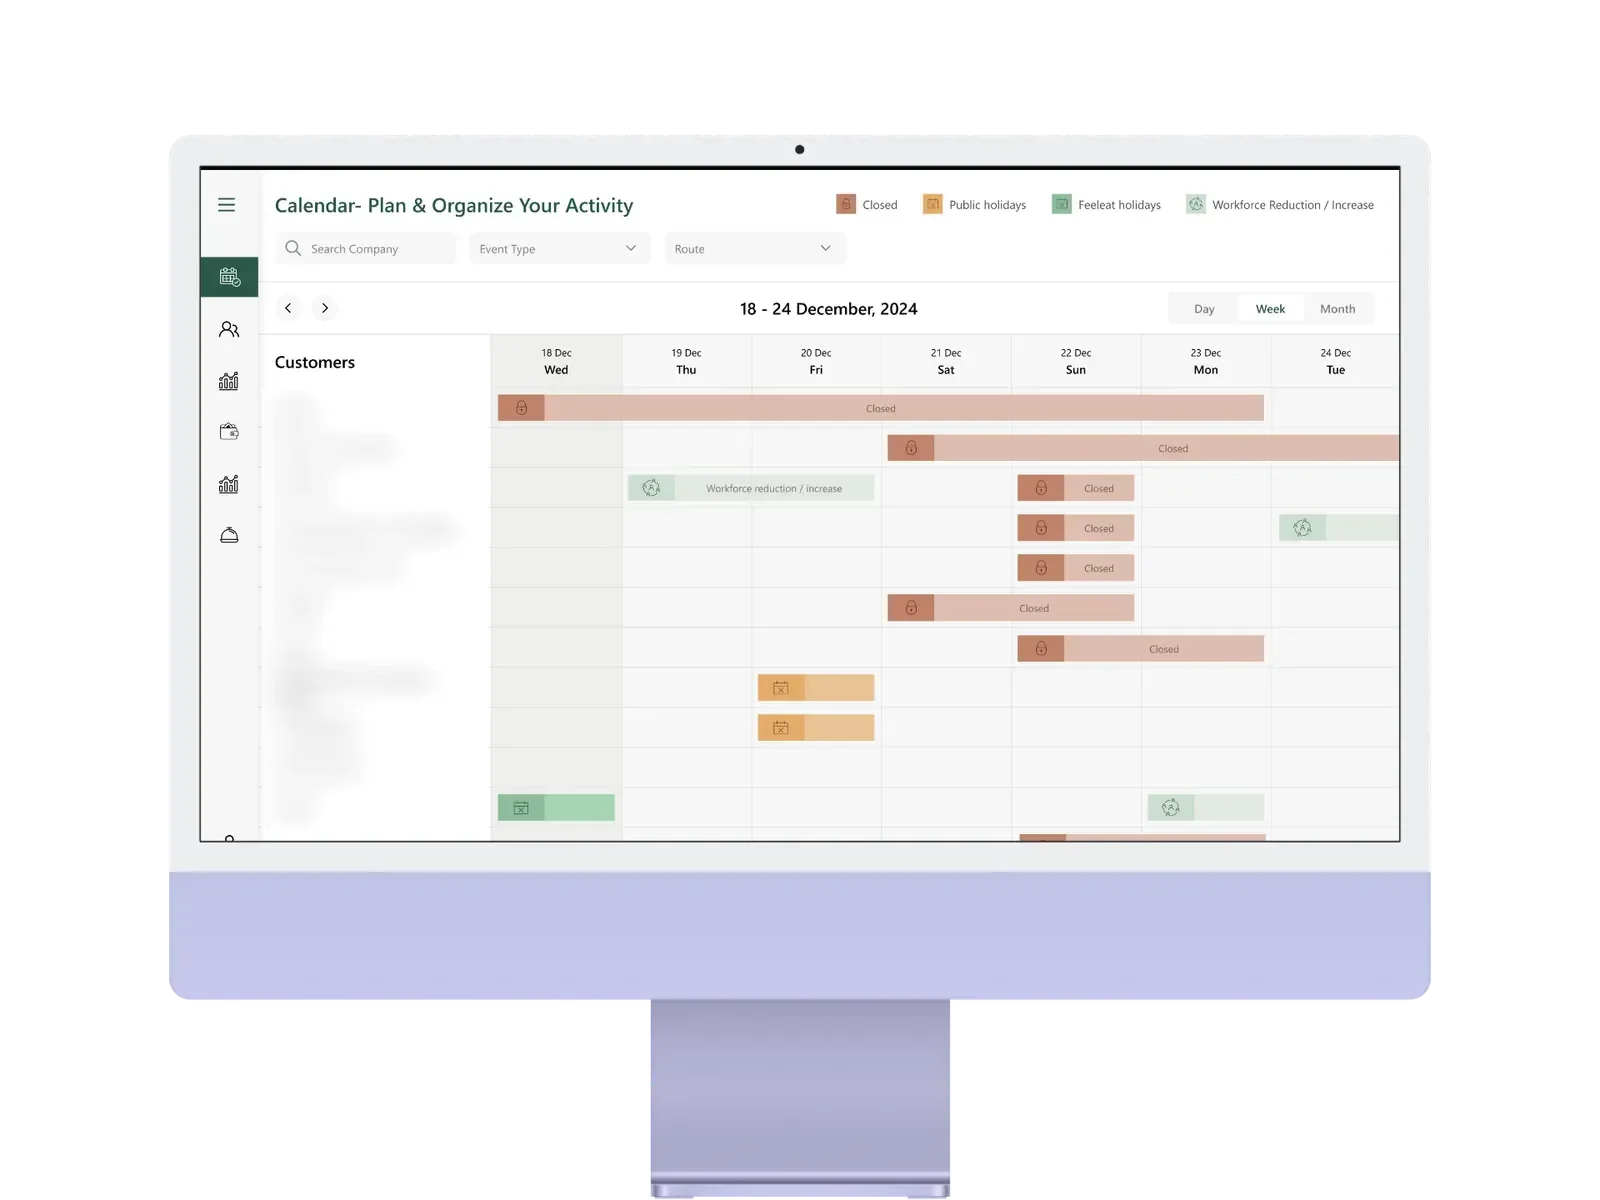
FeelEat
Abbiamo costruito il DevOps di FeelEat su DigitalOcean: servizi impacchettati in container Docker ed eseguiti su Kubernetes. LeadTrack AI gira su AWS, anch'esso con Docker, con il DevOps curato dallo stesso team.
Scelti per il problema, non per il CV.
AWS o DigitalOcean, Docker e Kubernetes, tutto automatizzato — la toolchain che la tua prossima assunzione già conosce.
Un solo team. Zero passaggi di consegne.
Le discipline più spesso combinate con DevOps & cloud — stessa architettura, stessi ingegneri, nessuna tassa di integrazione.
Domande, risposte.
Ciò che gli acquirenti di DevOps & cloud ci chiedono più spesso. Per il resto — descrivilo in un brief, un ingegnere senior risponde entro un giorno lavorativo.
Mettilo in un brief. Un ingegnere senior — non un commerciale — ti risponde entro un giorno lavorativo.
Potete riprendere in carico un'infrastruttura che già gestiamo?
Sì — è l'incarico più comune. Auditiamo, importiamo tutto in Terraform e stabilizziamo prima di cambiare qualsiasi cosa. Nessuna migrazione big-bang: la tua disponibilità non è mai la posta in gioco.
Ridurrà la nostra fattura cloud?
Spesso sì, grazie al corretto dimensionamento, allo scheduling e alla pulizia dello storage, ma indichiamo una cifra solo dopo l'audit. Soprattutto, i costi diventano visibili e attribuiti: la fattura smette di essere una sorpresa mensile.
Ci serve comunque la nostra assunzione DevOps interna?
Non necessariamente. Possiamo gestire l'operatività per te, oppure costruire la piattaforma e formarci sopra la tua nuova persona. In entrambi i casi codice e account cloud sono tuoi, quindi nessun vincolo.
Come gestite la conformità — GDPR, SOC 2, ISO?
L'infrastruttura come codice rende la conformità dimostrabile: audit trail, revisioni degli accessi e prove generate automaticamente.
Ci serve Kubernetes?
Probabilmente no. La maggior parte dei team con meno di 50 ingegneri è servita meglio da un PaaS gestito (Vercel, Fly, Railway, ECS, Cloud Run). Adottiamo Kubernetes quando la sua complessità operativa è giustificata da una scala reale o da requisiti di conformità.
E il disaster recovery?
Progettiamo gli obiettivi RTO/RPO in base all'esigenza di business (non al massimalismo dei fornitori), implementiamo backup automatizzati con procedure di ripristino testate e possiamo fare prove di ripristino regolari quando le tue regole di conformità lo richiedono.
Com'è davvero fatta una buona osservabilità?
I tre pilastri realizzati con intenzione: log strutturati, metriche e trace distribuiti correlati da un ID di richiesta, con OpenTelemetry come livello di strumentazione per non restare vincolati a un unico fornitore. Il test: un ingegnere di reperibilità riesce a passare da un alert alla causa radice in pochi minuti senza fare SSH su una macchina. Le dashboard che nessuno guarda non sono osservabilità.
Come rendete i deploy abbastanza sicuri da farli più volte al giorno?
Trunk-based development, test automatizzati come gate di merge e delivery progressiva — canary o blue-green con rollback automatico su regressione del tasso di errore o di latenza. I feature flag disaccoppiano il deploy dalla release, così rilasciare il codice e attivarlo diventano decisioni separate. Tanti piccoli deploy frequenti sono più sicuri di rari deploy grandi, il che è l'opposto dell'intuizione della maggior parte dei team.
Da quanto tempo non rilasci
senza trattenere il fiato?
Raccontaci il tuo stack, i tuoi giorni di deploy e il tuo ultimo incidente. Un ingegnere senior di infrastruttura risponde entro un giorno lavorativo con una valutazione onesta.