


A infraestrutura sem o pager às 3 da manhã.
Deploys automatizados, monitorização e segurança, para que os lançamentos sejam rotina.
Conteúdo revisado:
A sua infraestrutura devia ser a coisa mais aborrecida que possui.
Só reparamos na infraestrutura quando ela falha — no pico de tráfego, durante a demonstração, às 3 da manhã. As causas nunca são exóticas: servidores alterados à mão, deploys que dependem de uma única pessoa, alertas que ninguém lê e custos pelos quais ninguém responde.
Tornamo-la aborrecida de propósito. Tudo em código, cada deploy automatizado e reversível, cada sistema observável antes de descarrilar. Construímos todo o DevOps da FeelEat na DigitalOcean, com Kubernetes e Docker, e o da LeadTrack AI na AWS, com Docker.
Concebido para a calma.
As seis camadas de uma cloud de produção que deixa toda a gente dormir.
Arquitetura cloud
Ambientes múltiplos na AWS ou na DigitalOcean, bem dimensionados — pensados para a carga que tem de facto, não para um diagrama de referência.
CI / CD
Pipelines que testam, constroem e entregam a cada merge — com deploys progressivos e rollback num clique.
Segurança & monitorização
IAM de menor privilégio, gestão de segredos, trilhos de auditoria e alertas afinados para só acordar humanos quando um humano pode ajudar.
Infrastructure as Code
Terraform para cada recurso — revisível, reproduzível e reconstruível de raiz numa tarde.
Auto-scaling & controlo de custos
Capacidade que acompanha a procura e orçamentos com responsáveis — desempenho e fatura ambos sob controlo.
Resposta a incidentes
Runbooks, alertas automáticos 24 horas por dia e post-mortems sem culpa — com escala de on-call disponível num retainer de DevOps gerido.
Estabilizar, automatizar, esquecer.
Um caminho de migração que nunca aposta a sua disponibilidade num fim de semana de bascula.
01Auditar & mapear
Cada recurso, dependência e ponto único de falha documentado — incluindo aqueles que só um engenheiro conhecia.
02Codificar a verdade
A infraestrutura existente importada para Terraform. A partir daí, a mudança passa pela revisão, não pelo SSH.
03Automatizar a entrega
CI/CD com testes, staging e rollback. Os deploys passam de eventos temidos a não-eventos, diários.
04Observar & robustecer
Dashboards, alertas, testes de carga e revisão de segurança — depois, se quiser, operação contínua pela mesma equipa.
O seu produto pode ser o próximo caso nesta página.
Comece com um workshop gratuito de 4 horasKubernetes por baixo de uma operação food-tech.
Todo o DevOps por detrás do software da FeelEat, na DigitalOcean. Para a LeadTrack AI fizemos o mesmo na AWS.
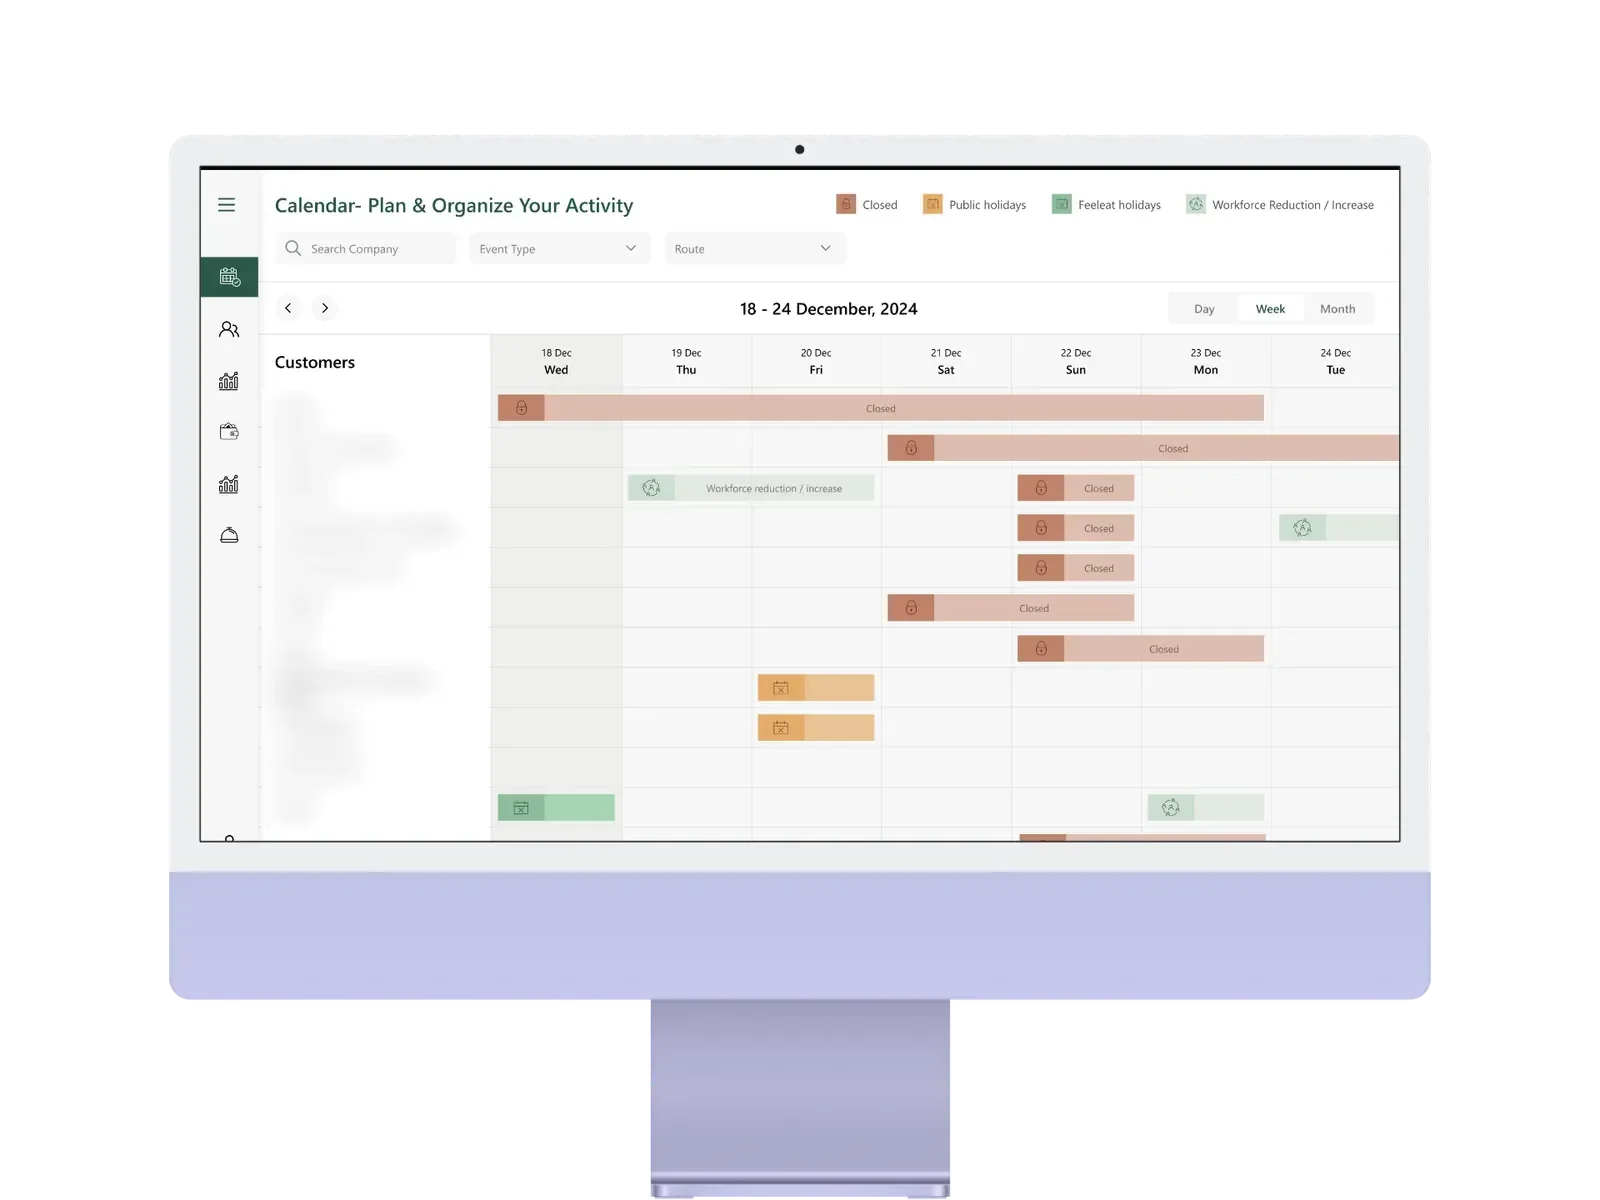
FeelEat
Construímos o DevOps da FeelEat na DigitalOcean: serviços empacotados em contentores Docker e executados em Kubernetes. A LeadTrack AI corre na AWS, também com Docker, com o DevOps a cargo da mesma equipa.
Escolhidas para o problema, não para o currículo.
AWS ou DigitalOcean, Docker e Kubernetes, tudo automatizado — a cadeia de ferramentas que a sua próxima contratação já conhece.
Uma só equipa. Zero passagens de testemunho.
As disciplinas mais frequentemente combinadas com DevOps & cloud — mesma arquitetura, mesmos engenheiros, sem taxa de integração.
Perguntas, respostas.
O que os compradores de DevOps & cloud mais nos perguntam. Para o resto — descreva-o num brief, um engenheiro sénior responde no prazo de um dia útil.
Coloque-o num briefing. Um engenheiro sénior — não um vendedor — responde no prazo de um dia útil.
Conseguem assumir uma infraestrutura que já exploramos?
Sim — é o trabalho mais comum. Auditamos, importamos tudo para Terraform e estabilizamos antes de mudar o que quer que seja. Sem migração big-bang: a sua disponibilidade nunca está em jogo na aposta.
Isto vai reduzir a nossa fatura de cloud?
Muitas vezes sim, com o dimensionamento correto, o agendamento e a limpeza do armazenamento, mas só indicamos um valor depois da auditoria. Sobretudo, os custos tornam-se visíveis e atribuídos: a fatura deixa de ser uma surpresa mensal.
Continuamos a precisar da nossa própria contratação DevOps?
Não necessariamente. Podemos assegurar a operação por si, ou construir a plataforma e formar nela a sua própria contratação. Em ambos os casos, o código e as contas cloud pertencem-lhe, por isso não fica preso a nós.
Como lidam com a conformidade — RGPD, SOC 2, ISO?
A infraestrutura em código torna a conformidade demonstrável: trilhos de auditoria, revisões de acesso e provas geradas automaticamente.
Precisamos de Kubernetes?
Provavelmente não. A maioria das equipas com menos de 50 engenheiros é melhor servida por um PaaS gerido (Vercel, Fly, Railway, ECS, Cloud Run). Adotamos Kubernetes quando a sua complexidade operacional é justificada por uma escala real ou por exigências de conformidade.
E a recuperação de desastres?
Concebemos os objetivos RTO/RPO para corresponder à necessidade de negócio (não ao maximalismo do fornecedor), implementamos backups automatizados com procedimentos de restauro testados, e podemos fazer testes de restauro regulares quando as suas regras de conformidade o exigirem.
Como é, na realidade, uma boa observabilidade?
Os três pilares feitos deliberadamente: logs estruturados, métricas e traces distribuídos correlacionados por um ID de pedido, com OpenTelemetry como camada de instrumentação para não ficar preso a um único fornecedor. O teste: consegue um engenheiro de on-call passar de um alerta à causa raiz em minutos sem fazer SSH a uma máquina? Os dashboards que ninguém vê não são observabilidade.
Como tornam os deploys suficientemente seguros para os fazer várias vezes por dia?
Desenvolvimento trunk-based, testes automatizados como porta de merge, e entrega progressiva — canary ou blue-green com rollback automático perante regressão da taxa de erro ou de latência. As feature flags desacoplam o deploy da release, para que entregar código e ativá-lo sejam decisões separadas. Deploys pequenos e frequentes são mais seguros do que os grandes e raros, o que é o oposto da intuição da maioria das equipas.
Quando foi o último deploy
sem prender a respiração?
Fale-nos do seu stack, dos seus dias de deploy e do seu último incidente. Um engenheiro de infraestrutura sénior responde no prazo de um dia útil com uma leitura honesta.