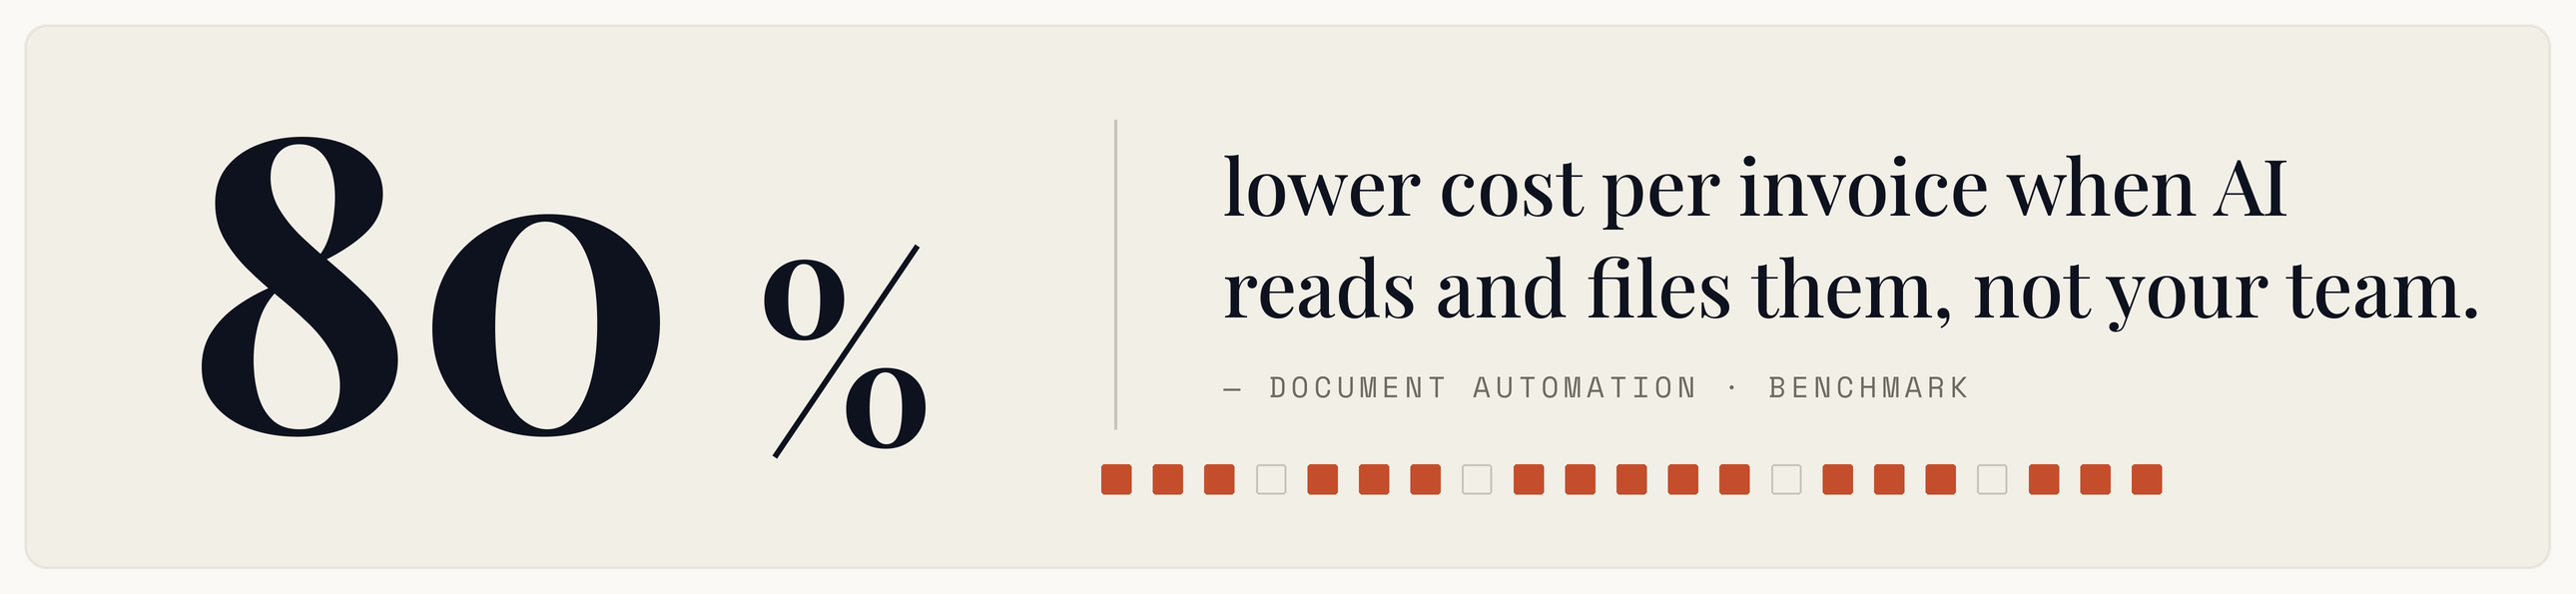
Irgendwo in Ihrem Finanzteam liest gerade eine Person ein PDF und tippt ab, was darin steht, in ein Formular. Das PDF wurde von einem Computer erzeugt. Das Formular speist eine Datenbank. Eine Maschine hat es geschrieben, eine Maschine wird es speichern — und dazwischen tippt es ein Mensch neu.
Diese Lücke ist seit dreissig Jahren offensichtlich. Was sich geändert hat: Die Technologie, sie zu schliessen, beherrscht endlich die unordentlichen Fälle — die immer der Grund waren, warum sie offen blieb.
Warum OCR nie genug war
Texterkennung löste die Umwandlung eines Textbilds in Text. Sie ist seit Jahrzehnten gut — und sie hat dieses Problem nicht gelöst, denn das Lesen der Zeichen ist der einfache Teil.
Der harte Teil ist das Verstehen. Eine Lieferantenrechnung hat eine Summe, einen Steuerbetrag, ein Fälligkeitsdatum und eine Bestellreferenz — aber jeder Lieferant ordnet sie anders an, beschriftet sie anders, platziert sie anders. Einer schreibt «Zahlbetrag», ein anderer «Offener Saldo», ein dritter setzt die Zahl in ein Kästchen ganz ohne Beschriftung.
Vorlagenbasierte Extraktion löste das, indem jedes Layout im Voraus konfiguriert wurde. Mit zwölf Lieferanten machbar, mit vierhundert unbeherrschbar — und kaputt, sobald jemand seine Rechnung neu gestaltet.
Moderne Dokumentenverarbeitung überspringt Vorlagen. Bei einer nie gesehenen Rechnung identifiziert sie die Summe, weil sie versteht, was eine Summe im Kontext ist — so, wie eine Person, die das Format dieses Lieferanten nie sah, sie trotzdem in Sekunden findet.
Die Pipeline, ehrlich beschrieben
Vier Stufen — und die Fehlermodi ballen sich in bestimmten.
Eingang. Dokumente kommen per E-Mail, Upload, Scanner oder geteiltem Ordner. Banal — und die Quelle eines erstaunlichen Anteils der Probleme: Anhänge tief in weitergeleiteten Ketten, zwölf Rechnungen in einem PDF, schräg fotografierte Bilder.
Klassifikation. Was ist das — eine Rechnung, ein Lieferschein, ein Vertrag, ein Kontoauszug? Wer hier danebenliegt, schickt das Dokument auf den falschen Extraktionspfad, und die Fehler wirken stromabwärts unerklärlich.
Extraktion. Die strukturierten Felder ziehen. Das ist der Teil, der sich dramatisch verbessert hat — und der Teil, den Anbieter vorführen.
Validierung und Routing. Stimmt die Summe mit den Positionen überein? Existiert die Bestellung? Ist das ein Duplikat vom letzten Monat? Diese Stufe trennt ein System, das Arbeit spart, von einem, das eine andere Art Arbeit erzeugt.
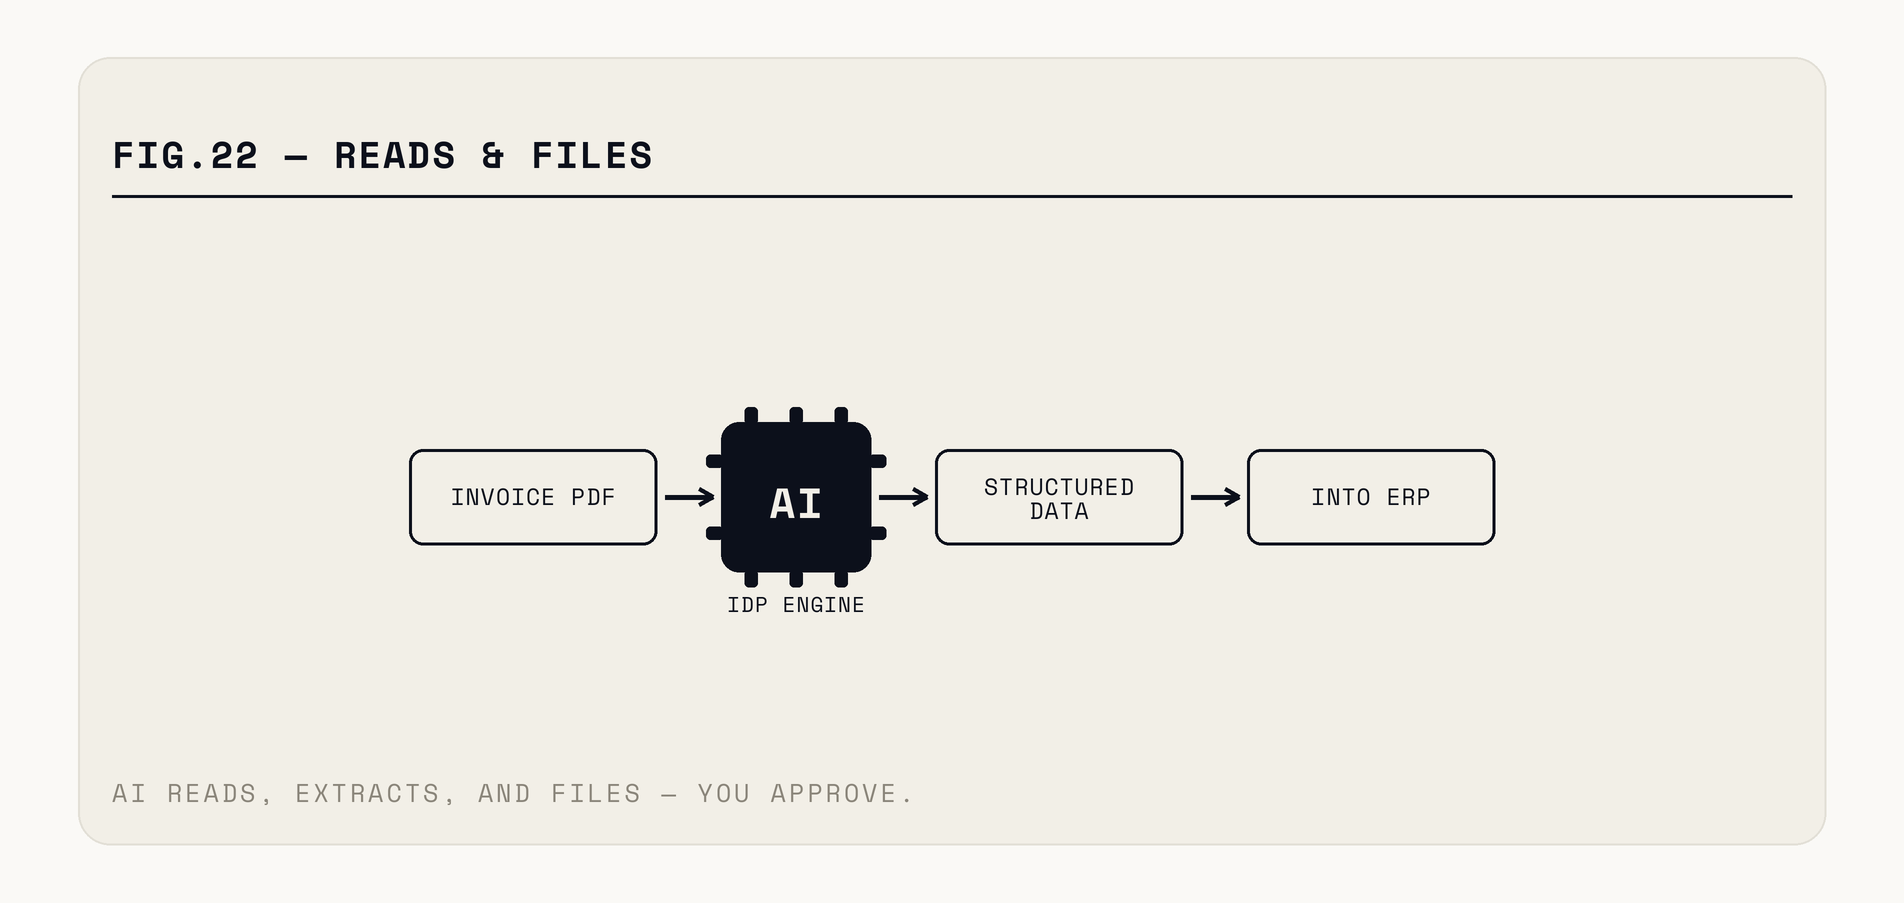
Abb. — Die Validierung ist, wo ein System aufhört, Daten zu produzieren, und anfängt, vertrauenswürdige Daten zu produzieren.
Wo es sich am schnellsten bezahlt macht
Kreditorenbuchhaltung ist das Standard-Erstprojekt, aus gutem Grund. Hohes Volumen, konsistente Dokumenttypen, ein offensichtliches Zielsystem — und Kosten pro Rechnung, die die meisten Finanzteams bereits beziffern können. Der Business Case schreibt sich selbst.
Spesenbelege sind das zweite — vor allem, weil die Alternative so schlecht ist. Fotografierte Quittungen, inkonsistente Formate, und ein Mitarbeiter, der eine Erstattung will, keine Datenerfassung.
Onboarding-Unterlagen — Ausweisdokumente, Adressnachweise, Formulare — wo der Engpass eine Person ist, die prüft, ob Felder über drei Dokumente hinweg übereinstimmen.
Vertragseingang ist fortgeschrittener und zunehmend verbreitet: Daten, Parteien, Verlängerungsfristen und Pflichten in etwas Durchsuchbares ziehen — damit niemand eine automatische Verlängerung entdeckt, nachdem sie verlängert hat.
Der rote Faden ist Volumen und Wiederholung. Ein Prozess mit dreissig Dokumenten im Monat rechtfertigt die Integrationsarbeit nicht — egal, wie mühsam er sich anfühlt.
Die Zahl, die alles entscheidet
Nicht die Genauigkeit — die Durchlaufquote ohne Eingriff. Wie viel Prozent der Dokumente durchlaufen, ohne dass ein Mensch sie berührt.
Genauigkeit führt in die Irre, weil sie über Felder völlig unterschiedlicher Wichtigkeit mittelt. Achtundneunzig Prozent Feldgenauigkeit klingt exzellent — und kann trotzdem heissen, dass auf fast jedem Dokument irgendetwas falsch ist. Dann wird jedes Dokument geprüft, und Sie haben nichts gespart.
Die Durchlaufquote bildet direkt auf Kosten ab. Laufen zwei Drittel der Rechnungen unberührt durch, haben Sie zwei Drittel der Arbeit entfernt — und das verbleibende Drittel ist, worauf sich Ihre Prüfer konzentrieren.
Entwerfen Sie explizit dafür. Die Extraktion sollte pro Feld einen Konfidenzwert liefern, Dokumente unter der Schwelle wandern in eine menschliche Warteschlange — und die Schwelle ist eine Geschäftsentscheidung: hoch für alles, was Geld bewegt, niedriger, wo ein Fehler ohnehin stromabwärts auffällt.
Was schiefgeht
Mehrdeutigkeit, mit Selbstbewusstsein behandelt. Der gefährliche Fehler ist nicht das leere Feld — es ist der plausible falsche Wert. Ein aus dem falschen Kästchen gelesenes Datum ist eine wohlgeformte Zahl, die jede Formatprüfung besteht. Validierung gegen andere Daten — existiert die Bestellung, stimmt die Summe mit den Positionen — fängt diese Fälle, wo Feld-Konfidenz es nicht tut.
Mehrseitige und Mehrfach-Dokumente. Ein einzelnes PDF mit drei Rechnungen, oder eine Rechnung, deren Positionen über Seiten laufen. In der Praxis häufig, oft falsch behandelt — und es lohnt sich, mit Ihren tatsächlich schlimmsten Dateien zu testen statt mit sauberen Mustern.
Handschrift und schlechte Scans. Besser als früher, weiterhin die Schwachstelle. Ist ein nennenswerter Teil Ihres Eingangs handschriftlich, messen Sie diese Teilmenge separat, bevor Sie sich festlegen.
Compliance. Dokumente enthalten persönliche und finanzielle Daten — wo sie verarbeitet werden und wie lange sie aufbewahrt werden, sind echte Fragen. Passiert die Verarbeitung ausserhalb Ihrer Jurisdiktion, gehört das vor dem Rollout beantwortet, nicht während eines Audits.
Die Menschen-Frage — schlecht und gut behandelt
Ein Dokumentenverarbeitungs-Projekt entfernt Arbeit, die Menschen heute tun — und das zu beschönigen schadet dem Rollout mehr als jedes technische Problem.
Teams, die das gut machen, sind konkret darin, was sich ändert. Die Datenerfassung schrumpft; die Ausnahmebehandlung wächst. Die Person, die früher vierhundert Rechnungen eintippte, prüft jetzt die sechzig, bei denen das System unsicher war, verfolgt die wirklich problematischen — und hat Zeit für die Lieferantenanfragen, die vorher nie beantwortet wurden. Das ist ein besserer Job, und es lohnt sich, das laut zu sagen.
Teams, die es schlecht machen, verkünden ein Effizienzprogramm, bieten keine Klarheit — und wundern sich dann, warum die Ausnahmequote des Piloten mysteriös hoch ist. Menschen, die vermuten, ein System solle sie ersetzen, sind nicht motiviert, ihm zum Erfolg zu verhelfen — und sie sind die, die wissen, welche Dokumente es brechen.
Es gibt auch ein echtes Wissensrisiko. Die Person, die seit neun Jahren Rechnungen verarbeitet, weiss, dass ein bestimmter Lieferant die Steuer immer in die falsche Spalte schreibt. Dieses Wissen steht in keinem System — und geht sie, bevor es erfasst ist, sinkt Ihre Durchlaufquote leise, und niemand weiss warum. Interviewen Sie sie beim Entwerfen der Validierungsregeln — es ist die billigste verfügbare Qualitätsverbesserung.
Anfangen ohne Grossprogramm
Nehmen Sie einen Dokumenttyp, eine Quelle, ein Zielsystem. Rechnungen, die in einem Postfach ankommen und in ein Hauptbuch gehen.
Messen Sie zuerst die heutigen Kosten — Dokumente pro Monat, Minuten pro Stück, Fehlerquote, und was ein verpasster Skonto kostet. Ohne diese Basislinie können Sie keine Verbesserung nachweisen — und nicht nachgewiesene Verbesserungen werden gestrichen.
Seien Sie auch am Integrationsende realistisch. Die Daten zu extrahieren ist nur die halbe Lösung — sie müssen im Hauptbuch landen, dem richtigen Lieferantendatensatz zugeordnet, mit der richtigen Kostenstelle. Diese letzte Meile ist gewöhnliche Integrationsarbeit, dort geht der Grossteil des Zeitplans hin — und sie ist in jeder Anbieter-Demo unsichtbar, weil die Demo bei einem Bildschirm mit extrahierten Feldern endet.
Lassen Sie das System einige Wochen neben den Menschen laufen, statt sie zu ersetzen. Vergleichen Sie die Ergebnisse. Die Abweichungen sind die nützlichen Daten: Manche sind Systemfehler — und erstaunlich viele offenbaren, dass Ihre Leute still einen Fall behandelt haben, den niemand dokumentiert hat.
Erhöhen Sie die Autonomie dann schrittweise, nach Dokumenttyp und Lieferant, und halten Sie die Konfidenzschwelle konservativ, bis die Durchlaufquote langweilig ist.
Eine Gewohnheit, die sich von Anfang an lohnt: das Originaldokument mit jedem extrahierten Datensatz verknüpft halten. Wird eine Zahl sechs Monate später angezweifelt — und das wird sie —, verwandelt der Ein-Klick-Zugriff auf die Quelle eine forensische Übung in eine Fünf-Sekunden-Prüfung. Systeme, die nur die extrahierten Werte speichern, sparen dieselbe Arbeit und verlieren die Fähigkeit, sie zu verteidigen — ein schlechter Tausch bei allem, was ein Auditor ansehen könnte.
Extraktion mit Quellenlink — der Fünf-Sekunden-Check statt der forensischen Übung — ist der Standard, nach dem wir IDP-Systeme bauen. Wenn Ihre Dokumente noch durch Postfächer laufen, zeigen Sie uns eine Woche davon.