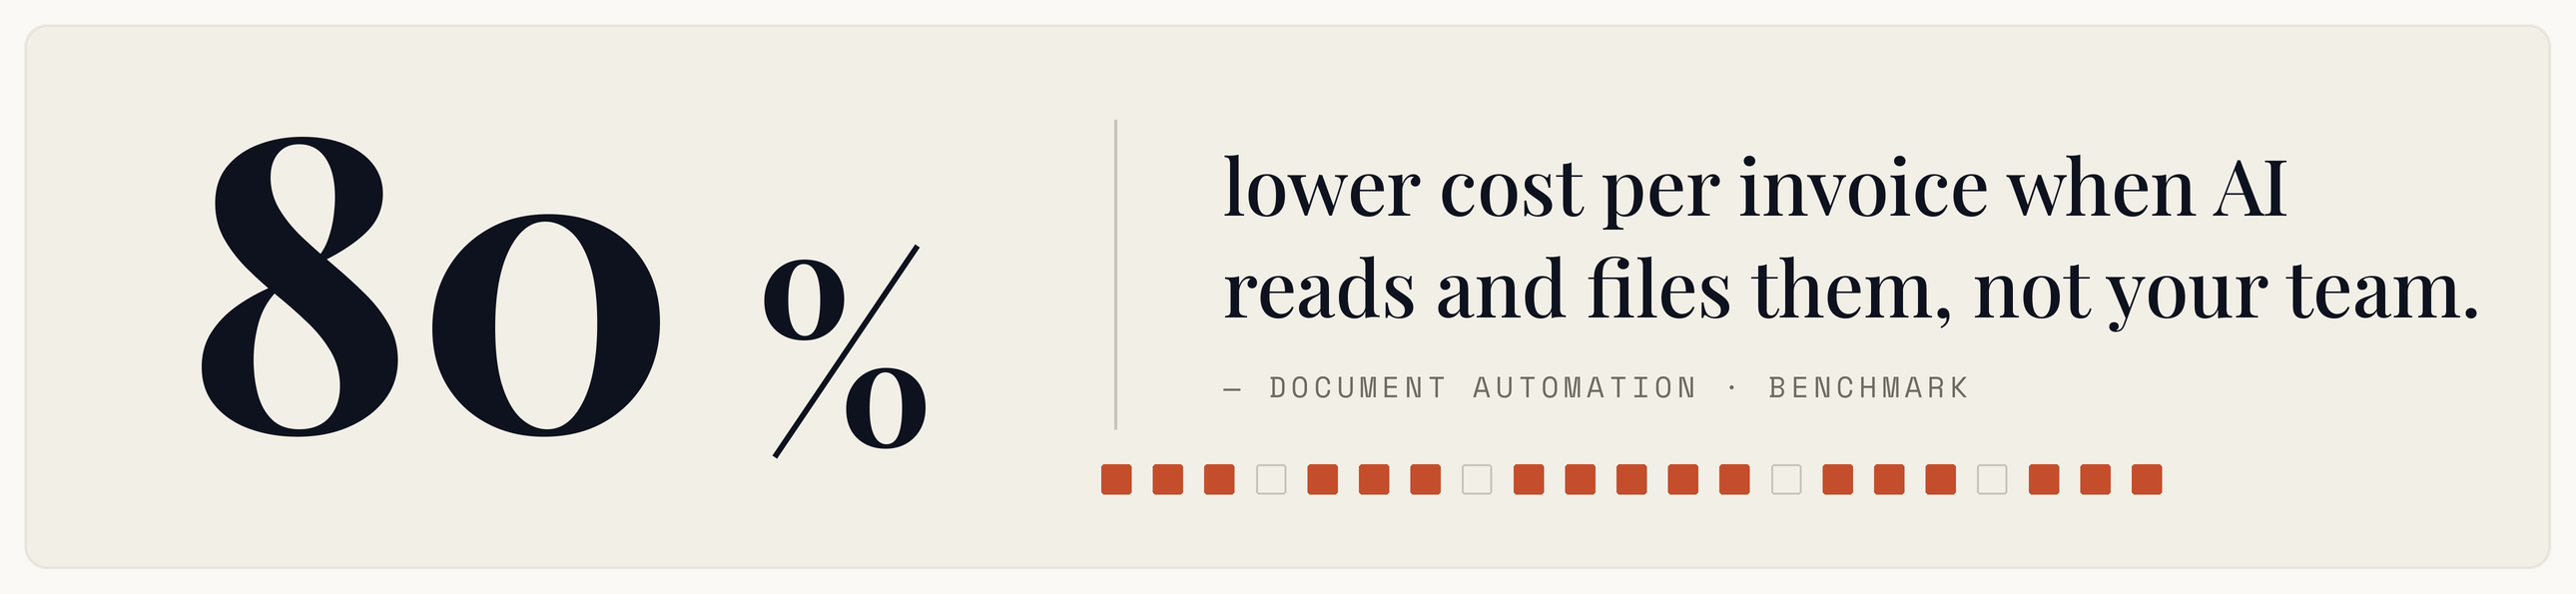
Quelque part dans votre équipe finance, une personne lit un PDF et tape ce qu'il contient dans un formulaire. Le PDF a été généré par un ordinateur. Le formulaire alimente une base de données. Une machine l'a écrit, une machine va le stocker — et entre les deux, un humain le retape.
Cet écart est évident depuis trente ans. Ce qui a changé : la technologie pour le combler gère enfin les cas désordonnés — qui ont toujours été la raison pour laquelle il restait ouvert.
Pourquoi l'OCR n'a jamais suffi
La reconnaissance optique a résolu la conversion d'une image de texte en texte. Elle est bonne depuis des décennies, et elle n'a pas résolu ce problème — parce que lire les caractères est la partie facile.
La partie difficile, c'est comprendre. Une facture fournisseur a un total, un montant de taxe, une date d'échéance et une référence de commande — mais chaque fournisseur les dispose autrement, les étiquette autrement, les place ailleurs. L'un écrit « Montant dû », l'autre « Solde à payer », un troisième met le chiffre dans une case sans aucune étiquette.
L'extraction par gabarits gérait cela en configurant chaque mise en page à l'avance. Faisable avec douze fournisseurs, ingérable avec quatre cents — et cassée dès que quelqu'un redessine sa facture.
Le traitement documentaire moderne saute les gabarits. Devant une facture jamais vue, il identifie le total parce qu'il comprend ce qu'est un total en contexte — comme une personne qui n'a jamais vu le format de ce fournisseur le trouve quand même en quelques secondes.
La chaîne, décrite honnêtement
Quatre étapes — et les modes d'échec se concentrent dans certaines.
L'ingestion. Les documents arrivent par e-mail, upload, scanner ou dossier partagé. Banal — et source d'une part surprenante des problèmes : pièces jointes enfouies dans des chaînes transférées, douze factures dans un seul PDF, images photographiées de travers.
La classification. Qu'est-ce que c'est — une facture, un bon de livraison, un contrat, un relevé bancaire ? Se tromper ici envoie le document sur le mauvais chemin d'extraction, et les erreurs paraissent inexplicables en aval.
L'extraction. Tirer les champs structurés. C'est la partie qui s'est améliorée de façon spectaculaire — et celle que les éditeurs montrent en démo.
La validation et le routage. Le total correspond-il aux lignes ? La commande existe-t-elle ? Est-ce un doublon du mois dernier ? Cette étape sépare un système qui économise du travail d'un système qui en crée un d'un autre genre.
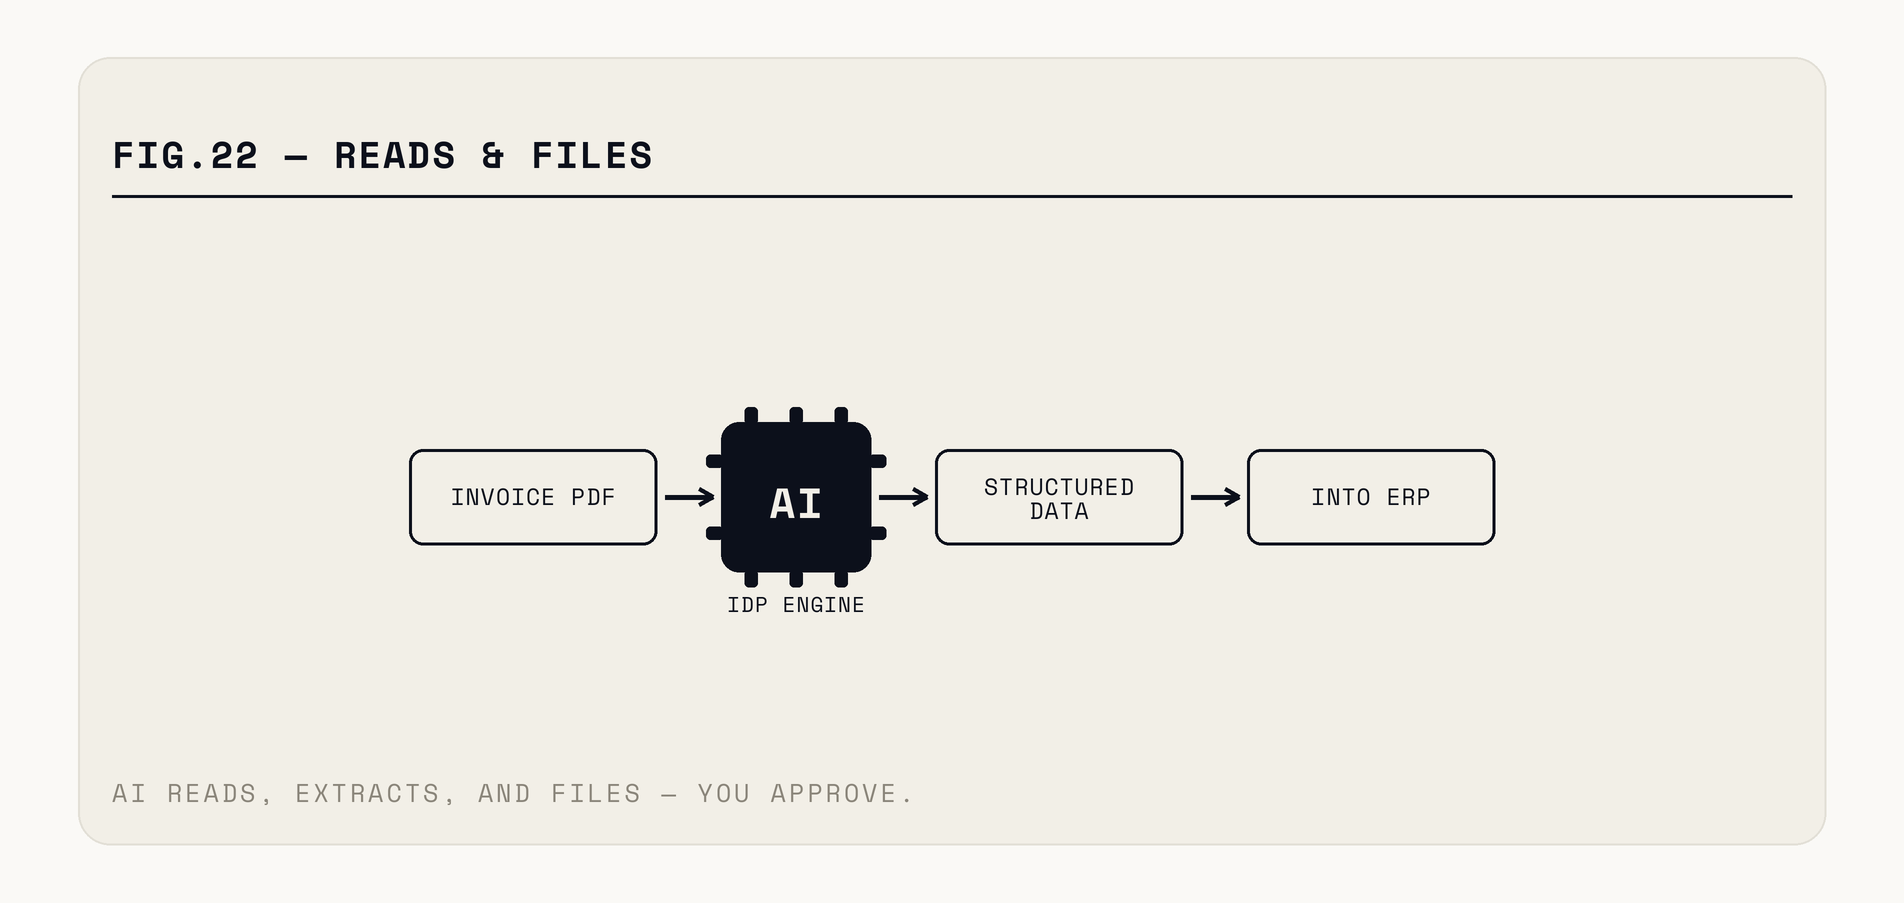
Fig. — La validation, c'est là qu'un système cesse de produire des données et commence à produire des données fiables.
Où ça se rembourse le plus vite
La comptabilité fournisseurs est le premier déploiement classique, à bon droit. Gros volume, types de documents constants, un système cible évident — et un coût par facture que la plupart des équipes finance savent déjà citer. Le business case s'écrit tout seul.
Les justificatifs de frais, ensuite — surtout parce que l'alternative est mauvaise. Reçus photographiés, formats incohérents, et un employé qui veut un remboursement, pas de la saisie.
Les dossiers d'onboarding — pièces d'identité, justificatifs de domicile, formulaires — où le goulot est une personne vérifiant que les champs concordent sur trois documents.
L'entrée des contrats est plus avancée et de plus en plus courante : extraire dates, parties, clauses de renouvellement et obligations vers quelque chose d'interrogeable — pour que personne ne découvre une tacite reconduction après qu'elle a reconduit.
Le fil conducteur : volume et répétition. Un processus à trente documents par mois ne justifie pas le travail d'intégration, quelle que soit sa pénibilité ressentie.
Le chiffre qui décide de tout
Pas la précision — le taux de traitement sans intervention. Quel pourcentage de documents aboutit sans qu'un humain les touche.
La précision trompe parce qu'elle moyenne des champs d'importance très inégale. Quatre-vingt-dix-huit pour cent de précision par champ sonne excellent — et peut quand même signifier que presque chaque document contient une erreur. Donc chaque document est relu. Donc vous n'avez rien économisé.
Le taux sans intervention se traduit directement en coût. Si deux tiers des factures passent sans être touchées, vous avez retiré deux tiers du travail — et le tiers restant est là où vos relecteurs se concentrent.
Concevez pour cela explicitement. L'extraction doit retourner un score de confiance par champ, les documents sous le seuil partent en file humaine — et le seuil est une décision métier : haut pour tout ce qui déplace de l'argent, plus bas là où une erreur est de toute façon rattrapée en aval.
Ce qui tourne mal
L'ambiguïté traitée avec assurance. L'échec dangereux n'est pas le champ vide — c'est la valeur fausse plausible. Une date lue dans la mauvaise case est un nombre bien formé qui passe tous les contrôles de format. La validation contre d'autres données — la commande existe-t-elle, le total colle-t-il aux lignes — attrape ces cas là où la confiance par champ ne le fait pas.
Les fichiers multi-pages et multi-documents. Un seul PDF contenant trois factures, ou une facture dont les lignes courent sur plusieurs pages. Courant en pratique, souvent mal géré — et à tester avec vos pires fichiers réels plutôt qu'avec des échantillons propres.
L'écriture manuscrite et les mauvais scans. Mieux qu'avant, toujours le point faible. Si une part significative de vos entrées est manuscrite, mesurez ce sous-ensemble séparément avant de vous engager.
La conformité. Les documents contiennent des données personnelles et financières — où ils sont traités et combien de temps ils sont conservés sont de vraies questions. Si le traitement se fait hors de votre juridiction, cela se répond avant le déploiement, pas pendant un audit.
La question humaine, bien et mal traitée
Un projet de traitement documentaire retire du travail que des gens font aujourd'hui — et prétendre le contraire abîme le déploiement plus que n'importe quel problème technique.
Les équipes qui gèrent bien sont précises sur ce qui change. La saisie rétrécit ; le traitement des exceptions grandit. La personne qui saisissait quatre cents factures relit maintenant les soixante sur lesquelles le système doutait, poursuit les vraiment problématiques — et a du temps pour les questions fournisseurs qui ne recevaient jamais de réponse. C'est un meilleur métier, et ça vaut la peine de le dire tout haut.
Les équipes qui gèrent mal annoncent un programme d'efficacité, n'offrent aucune clarté — puis s'étonnent que le taux d'exceptions du pilote soit mystérieusement élevé. Les gens qui soupçonnent un système d'être là pour les remplacer ne sont pas motivés à le faire réussir — et ce sont eux qui savent quels documents le cassent.
Il y a aussi un vrai risque de savoir. La personne qui traite les factures depuis neuf ans sait que tel fournisseur met toujours la taxe dans la mauvaise colonne. Ce savoir n'est dans aucun système — et si elle part avant qu'il soit capturé, votre taux sans intervention baisse en silence et personne ne sait pourquoi. Interviewez-la pendant la conception des règles de validation — c'est l'amélioration de qualité la moins chère disponible.
Commencer sans grand programme
Prenez un type de document, une source, un système cible. Les factures arrivant dans une boîte mail, allant dans un grand livre.
Mesurez d'abord le coût actuel — documents par mois, minutes par pièce, taux d'erreur, et ce que coûte un escompte de paiement anticipé manqué. Sans cette référence, vous ne pouvez pas démontrer l'amélioration — et les améliorations non démontrées se font couper.
Soyez réaliste aussi sur le bout intégration. Extraire les données n'est que la moitié d'un système qui marche — elles doivent atterrir dans votre grand livre, rattachées à la bonne fiche fournisseur, avec le bon centre de coûts. Ce dernier kilomètre est du travail d'intégration ordinaire, c'est là que part l'essentiel du planning — et il est invisible dans toutes les démos, parce que la démo s'arrête à un écran de champs extraits.
Faites tourner le système à côté des humains quelques semaines plutôt que de les remplacer. Comparez les sorties. Les désaccords sont les données utiles : certains sont des erreurs du système — et un nombre surprenant révèle que vos gens géraient en silence un cas que personne n'avait documenté.
Puis élevez l'autonomie progressivement, par type de document et par fournisseur, en gardant le seuil de confiance prudent jusqu'à ce que le taux sans intervention devienne ennuyeux.
Une habitude à intégrer dès le départ : garder le document d'origine lié à chaque enregistrement extrait. Quand un chiffre sera contesté six mois plus tard — et il le sera —, pouvoir ouvrir la source en un clic transforme un exercice médico-légal en vérification de cinq secondes. Les systèmes qui ne stockent que les valeurs extraites économisent le même travail et perdent la capacité de le défendre — un mauvais échange pour tout ce qu'un auditeur pourrait regarder.
L'extraction liée à la source — la vérification en cinq secondes plutôt que l'exercice de police scientifique — c'est le standard de nos systèmes IDP. Si vos documents passent encore par des boîtes mail, montrez-nous une semaine de flux.