Machine Learning sagt voraus, wie viel jeder Standort verkauft.
Eine Machine-Learning-Plattform, die die Nachfrage pro Standort und Gericht aus vergangenen Verkäufen und Live-Daten der Kühlschränke vorhersagt. Teams planen damit Bestand, Personal und Ausgaben.
Jeden Tag stellt sich die Frage, wie viel gekocht wird.
Bei FeelEat trafen erfahrene Planer diese Entscheidung, gestützt auf Tabellen.
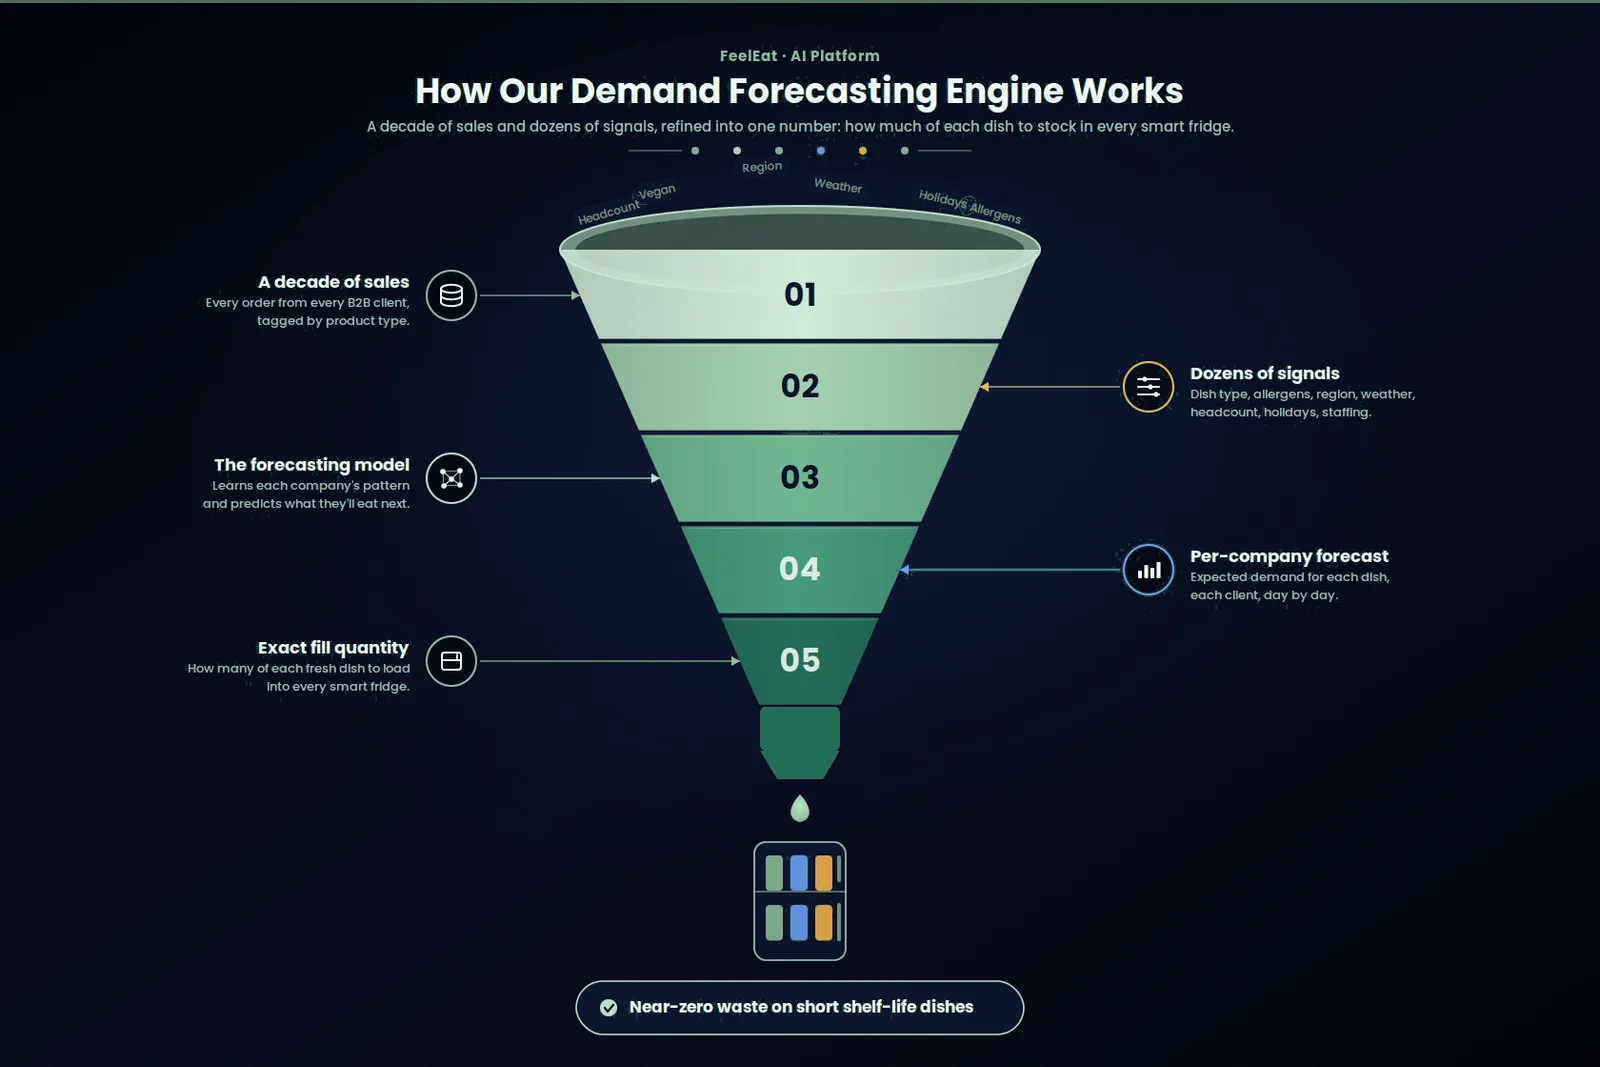
Wir haben eine Plattform gebaut, die Verkaufshistorie, Jahreszeit, Wetter und Live-Daten aus den Kühlschränken zu einer Nachfrageprognose für jeden Standort und jedes Gericht zusammenführt. Bestellungen und Nachschub werden jetzt danach geplant.
Im Betrieb ist die Prognose zu 98% genau. Fehlbestände sind um 58% gesunken, Überbestände um 41%.
Die Planung hielt nicht Schritt, als das Kühlschranknetz wuchs.
Erfahrene Planer machten an den Standorten, die sie kannten, gute Arbeit.
Überproduktion kostet Geld, leere Kühlschränke ebenso.
Die Planer hatten nur ihr eigenes Urteil und eine Tabelle.
- Überproduktion: unverkaufte Mahlzeiten landen am Ende jedes Tages im Abfall.
- Fehlbestände: ein leerer Kühlschrank am Mittag bedeutet verlorenen Umsatz und unzufriedene Kunden.
- Frühere Saisons ungenutzt: ältere Verkaufsdaten wurden nicht systematisch genutzt.
- Wissen an einem Standort: die Erfahrung jedes Planers blieb bei ihm.
Planer bekommen eine Prognose für jeden Standort und jedes Gericht.
Damit entscheiden sie, was gekocht und eingelagert wird, und sie sehen, wie genau frühere Prognosen waren.
- Überprüfte Genauigkeit: jede Prognose wird mit den echten Verkäufen verglichen.
- Eingangsdaten: Verkaufs- und Kühlschrankdaten, eingelesen, sobald sie anfallen.
- Bestellpläne: Bestellmengen und Personalpläne auf Basis der Prognose.
- Automatisches Neutraining: das Modell lernt neu, wenn Menüs wechseln und neue Standorte öffnen.
Die Plattform macht aus Verkaufsdaten Bestellmengen.
Pipelines versorgen die Modelle mit Daten, und Prüfungen überwachen, wie genau die Ergebnisse bleiben.
Dateneingang
Verkaufshistorie, Kalenderdaten und Live-Daten der Kühlschränke, automatisch über Datenpipelines eingelesen.
Nachfrageprognose-Modelle
Vorhersagen für jeden Standort und jedes Gericht, für die Tage, für die Planer bestellen.
Bestellplanung
Prognosen, übersetzt in Bestellmengen und Produktionspläne.
Personal- & Ausgabenplanung
Dieselbe Prognose dient der Schichtplanung und den Einkaufsbudgets.
Warnungen zur Genauigkeit
Warnungen, wenn sich das Nachfragemuster ändert und die Verkäufe von der Prognose abweichen.
Geplantes Neutraining
Modelle trainieren automatisch mit neuen Daten, und ein neues Modell ersetzt das alte nur, wenn es besser ist.
Mit den Betreibern haben wir bestimmt, was eine falsche Prognose kostet.
Bevor die Modellierung begann, wurden eine weggeworfene Mahlzeit und ein leerer Kühlschrank gegeneinander abgewogen.
Konzeption
Mit den Betreibern vereinbart, wie eine Prognose bewertet wird.
Design
Planungsansichten, die sagen, was gekocht werden soll.
Entwicklung
Datenimport, die Modelle und das automatische Neutraining.
Einführung
Nach einer Testphase Standort für Standort umgestellt.
Bringen Sie Ihre Version des Forecasting Model-Problems mit. Vier Stunden, kostenlos, mit dem Team, das dieses Projekt umgesetzt hat.
Kostenlosen Workshop buchenWas uns nachts wachgehalten hat.
Probleme, die wir lösen mussten.
Testphase neben den Planern
Die Planer wollten sehen, dass die Prognose funktioniert, bevor sie sich darauf verliessen. In einer Testphase lief sie neben ihren eigenen Plänen, und umgestellt wurde erst, als die Prognose besser abschnitt als die Planer selbst.
Neue Standorte ohne Verkaufshistorie
Ein neuer Standort startet mit Prognosen, die von ähnlichen Standorten übernommen werden. Sie werden besser, sobald eigene Verkaufsdaten hinzukommen.
Menüs und Standorte ändern sich laufend
Die Nachfrage ändert sich, wenn Menüs wechseln oder neue Standorte öffnen. Die Modelle trainieren automatisch neu, und ihre Genauigkeit wird regelmässig geprüft.
Der Tech-Stack.
Die Modelle sind in Python mit PyTorch und XGBoost geschrieben. Airflow steuert die Datenpipelines, und PostgreSQL speichert die Daten und jede Modellversion, alles auf AWS.
Zahlen, auf die Inhaber schauen.
Ergebnisse bei FeelEat.
Im Betrieb gemessen, am tatsächlichen Verkauf.
Deutlich weniger leere Kühlschränke zur Mittagszeit.
Weniger Essen, das gekocht und dann weggeworfen wird.
Wollen Sie solche Zahlen? Das passiert, nachdem Sie uns schreiben.
Früher lief die Planung nach Gewohnheit und Bauchgefühl. Heute sagt uns die Prognose Kühlschrank für Kühlschrank, welche Gerichte wir liefern und wie viele, abgestimmt darauf, wer in der jeweiligen Firma arbeitet und was dort wirklich gekauft wird. Mein Team prüft den Plan, statt ihn von Grund auf zu erstellen.
Weiter entdecken.
Jedes Projekt hier ist live, bezahlt und erwirtschaftet Umsatz für seine Eigentümer.
Häufige Fragen
Schreiben Sie es in ein Briefing. Ein Senior-Engineer liest es und antwortet innerhalb eines Arbeitstages.
Was leistet die Plattform zur Nachfrageprognose?
Es ist eine Machine-Learning-Plattform von CODT Technologies, die aus vergangenen Verkäufen ableitet, was als Nächstes gekocht und eingelagert wird. Die Prognosen sind zu 98% genau und steuern Bestellungen und Nachschub bei FeelEat.
Welche Geschäftsergebnisse hat das Prognosemodell erzielt?
Fehlbestände sanken um 58% und Überbestände um 41%. Das heisst: weniger weggeworfenes Essen und weniger leere Kühlschränke.
Ist das Modell der schwierige Teil einer Prognoseplattform?
Nein. Das Modell selbst war der kleinere Teil der Arbeit. Der grösste Aufwand steckte in den Datenpipelines, in den Prüfungen, die warnen, wenn die Genauigkeit nachlässt, und in den Planungsansichten, die jeden Morgen angeschaut werden.
Ein Problem, das es wert ist,
gut gelöst zu werden?
Erzählen Sie uns von Ihrem Produkt, Ihrem Zeitplan und Ihren Rahmenbedingungen. Wir antworten innerhalb eines Werktags mit einer ehrlichen Einschätzung zu Fit, Umfang und dem richtigen Team.