


DevOps-Beratung und Cloud-Services für AWS, DigitalOcean und Kubernetes.
Automatisierte Deployments, Monitoring und Sicherheit, damit Releases zur Routine werden.
Inhalt geprüft:
Was eine DevOps-Beratung bei uns umfasst
Wir übernehmen laufende Systeme in kleinen Schritten, die sich rückgängig machen lassen: zuerst automatische Builds und Deployments, dann Monitoring und Alarme, dann Sicherheit und Backups. Releases werden Routine statt Nachtschicht. FeelEat betreiben wir auf DigitalOcean mit Kubernetes und Docker, LeadTrack AI auf AWS mit Docker.
Infrastruktur fällt nur auf, wenn sie ausfällt — beim Traffic-Peak, während der Demo, um 3 Uhr morgens. Die üblichen Ursachen sind nie exotisch: von Hand editierte Server, Deploys, die an einer Person hängen, Alerts, die niemand liest, und Kosten, die niemand verantwortet.
Wir machen sie mit Absicht langweilig. Alles als Code, jeder Deploy automatisiert und umkehrbar, jedes System beobachtbar, bevor es sich danebenbenimmt. Für FeelEat haben wir das komplette DevOps auf DigitalOcean aufgebaut, mit Kubernetes und Docker, für LeadTrack AI auf AWS, mit Docker.
Auf Ruhe ausgelegt.
Die sechs Schichten einer Produktions-Cloud, bei der alle schlafen können.
Cloud-Architektur
Passend dimensionierte Umgebungen auf AWS oder DigitalOcean, entworfen für die Last, die Sie tatsächlich haben.
CI / CD
Pipelines, die bei jedem Merge testen, bauen und ausliefern — mit gestaffelten Rollouts und Ein-Klick-Rollback.
Sicherheit & Monitoring
Least-Privilege-IAM, Secrets-Management, Audit-Trails und Alerts, die Menschen nur wecken, wenn Menschen helfen können.
Infrastructure as Code
Terraform für jede Ressource — reviewbar, reproduzierbar und an einem Nachmittag von Grund auf neu aufbaubar.
Auto-Scaling & Kostenkontrolle
Kapazität, die der Nachfrage folgt, und Budgets mit Verantwortlichen — Performance und Rechnung beide unter Kontrolle.
Incident Response
Runbooks, automatische Alerts rund um die Uhr und schuldfreie Post-mortems — eine On-Call-Rotation gibt es mit einem gemanagten DevOps-Retainer.
Stabilisieren, automatisieren, vergessen.
Wir übernehmen laufende Systeme in kleinen, umkehrbaren Schritten — Ihre Nutzer merken von der Übernahme nichts.
01Auditieren & kartieren
Jede Ressource, Abhängigkeit und jeder Single Point of Failure dokumentiert — auch die, von denen nur ein einziger Engineer wusste.
02Die Wahrheit kodifizieren
Bestehende Infrastruktur wird in Terraform importiert. Ab hier läuft jede Änderung über einen Pull Request mit Review statt über eine SSH-Session.
03Delivery automatisieren
CI/CD mit Tests, Staging und Rollback. Deploys werden von gefürchteten Ereignissen zu Nicht-Ereignissen — täglich.
04Beobachten & härten
Dashboards, Alerting, Lasttests und Security-Review — danach auf Wunsch laufender Betrieb durch dasselbe Team.
Ihr Produkt könnte der nächste Fall auf dieser Seite sein.
Kostenloser 4-Stunden-WorkshopKubernetes unter einem Food-Tech-Betrieb.
Das komplette DevOps hinter der Software von FeelEat, auf DigitalOcean. Für LeadTrack AI haben wir dasselbe auf AWS gemacht.
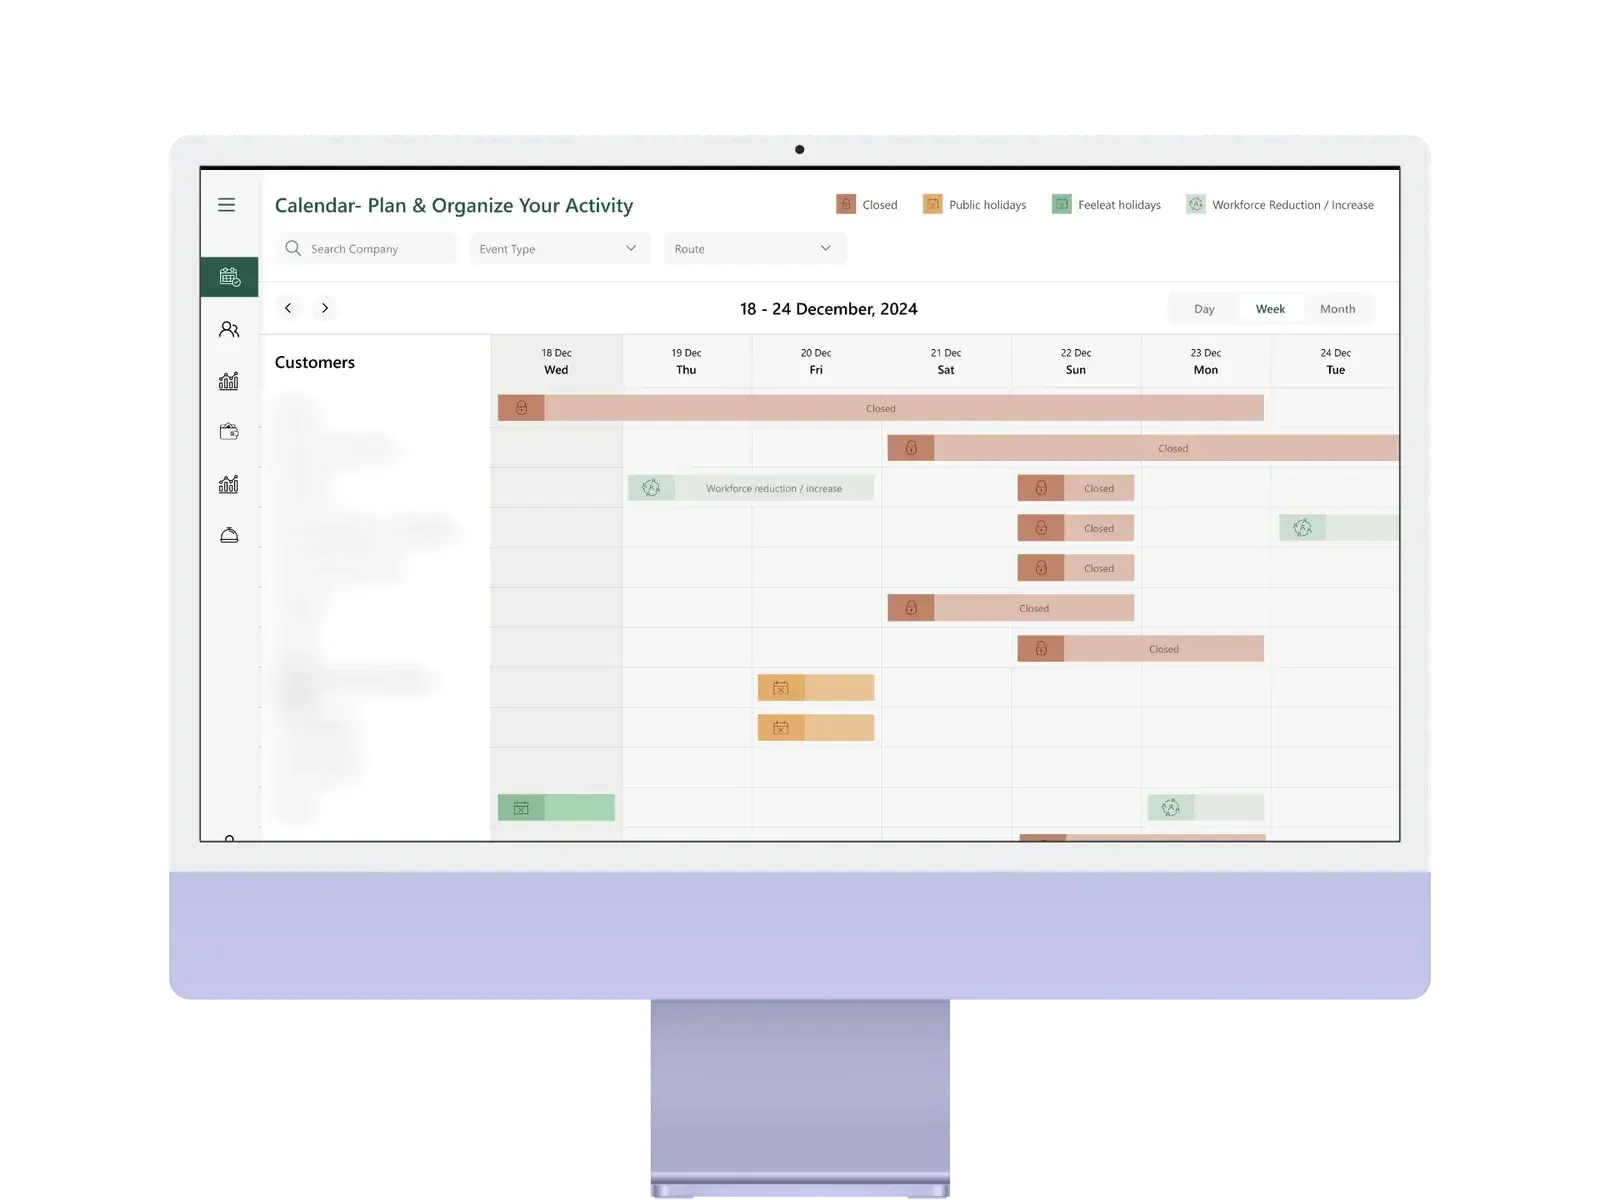
FeelEat
Für FeelEat haben wir das DevOps auf DigitalOcean aufgebaut: Services in Docker-Containern, betrieben auf Kubernetes. LeadTrack AI läuft auf AWS, ebenfalls mit Docker, mit DevOps vom selben Team.
Terraform und Co.
AWS oder DigitalOcean, Docker und Kubernetes, alles automatisiert: die Werkzeuge, die Ihre nächste Fachkraft schon kennt.
Was auf diesen Fundamenten läuft.
Die meisten unserer Infrastruktur-Engagements existieren, um eines dieser Produkte zu tragen.
Antworten aus dem Bereitschaftsdienst.
Übernahmen, Rechnungen, Kubernetes, Compliance — alles beantwortet von den Engineers, die diese Systeme betreiben.
Schreiben Sie es in ein Briefing. Ein Senior-Engineer liest es und antwortet innerhalb eines Arbeitstages.
Können Sie Infrastruktur übernehmen, die wir bereits betreiben?
Ja — das ist das häufigste Engagement. Wir auditieren, importieren alles in Terraform und stabilisieren, bevor wir irgendetwas ändern. Keine Big-Bang-Migration; Ihre Uptime steht nie auf dem Spiel.
Senkt das unsere Cloud-Rechnung?
Oft, durch Right-Sizing, Scheduling und aufgeräumten Storage, aber eine Zahl nennen wir erst nach dem Audit. Wichtiger noch: Kosten werden sichtbar und verantwortet, und die Rechnung hört auf, eine monatliche Überraschung zu sein.
Brauchen wir trotzdem einen eigenen DevOps-Hire?
Nicht unbedingt. Wir können den Betrieb für Sie übernehmen oder die Plattform bauen und Ihren eigenen Hire darauf einarbeiten. So oder so gehören Code und Cloud-Accounts Ihnen, es gibt also kein Lock-in.
Wie handhaben Sie Compliance — DSGVO, SOC 2, ISO?
Infrastructure as Code macht Compliance-Nachweise zum Nebenprodukt: Audit-Trails, Zugriffs-Reviews und Berichte entstehen automatisch.
Brauchen wir Kubernetes?
Wahrscheinlich nicht. Die meisten Teams unter 50 Ingenieuren sind mit managed PaaS (Vercel, Fly, Railway, ECS, Cloud Run) besser bedient. Wir setzen Kubernetes ein, wenn seine operative Komplexität durch echte Skalierung oder Compliance-Anforderungen gerechtfertigt ist.
Was ist mit Disaster Recovery?
Wir entwerfen RTO/RPO-Ziele passend zu dem, was das Geschäft tatsächlich braucht, implementieren automatisierte Backups mit getesteten Wiederherstellungsverfahren und können regelmässige Wiederherstellungsübungen durchführen, wenn Ihre Compliance-Regeln das verlangen.
Wie sieht gute Observability tatsächlich aus?
Die drei Säulen bewusst umgesetzt: strukturierte Logs, Metriken und verteilte Traces, korreliert über eine Request-ID, mit OpenTelemetry als Instrumentierungsschicht, damit Sie nicht an einen Anbieter gebunden sind. Der Test ist, ob ein On-Call-Ingenieur in Minuten von einem Alarm zur Ursache kommt, ohne sich per SSH auf eine Maschine zu verbinden. Wird ein Dashboard nie geöffnet, zählt es nicht.
Wie machen Sie Deploys sicher genug, um sie mehrmals täglich durchzuführen?
Trunk-based Development, automatisierte Tests als Merge-Gate und Progressive Delivery — Canary oder Blue-Green mit automatischem Rollback bei Fehlerraten- oder Latenzregression. Feature-Flags entkoppeln Deploy von Release, sodass Code ausliefern und ihn einschalten getrennte Entscheidungen sind. Häufige kleine Deploys sind sicherer als seltene grosse, was das Gegenteil der Intuition der meisten Teams ist.
Wann haben Sie zuletzt deployt,
ohne die Luft anzuhalten?
Erzählen Sie uns von Ihrem Stack, Ihrem Deploy-Tag und Ihrem letzten Incident. Ein Senior-Infrastruktur-Engineer antwortet innerhalb eines Werktags damit, was wir zuerst stabilisieren würden.