
Une responsable des achats rencontrée l'an dernier décrivait son métier comme « être une API très lente entre six systèmes ». Elle lisait un chiffre sur un tableau de bord, le tapait dans un autre, attendait un e-mail d'approbation, puis le tapait ailleurs. Personne n'a conçu ce poste. Il s'est accumulé.
Cette description est la raison pour laquelle le débat « agents IA contre SaaS » a du mordant. La question intéressante n'a jamais été de savoir si les agents savent écrire du texte. C'est de savoir si le logiciel que vous louez au siège a encore besoin d'un humain assis au milieu.
Ce qui sépare vraiment un agent d'une fonctionnalité
Presque tous les éditeurs SaaS livrent désormais quelque chose étiqueté IA. L'essentiel est une fonctionnalité : résume ce fil, rédige cette réponse, suggère la prochaine étape. Utile — mais ça attend d'être invoqué et ça vous rend le résultat.
Un agent se définit par ce qui se passe après la suggestion. Il prend un objectif, décide lui-même la séquence des étapes, appelle des outils pour les exécuter, vérifie si le résultat correspond à l'objectif — et réessaie quand ce n'est pas le cas. La boucle se ferme sans vous.
Cette distinction paraît académique jusqu'à ce qu'on regarde où va l'argent. Vous ne payez pas vraiment votre éditeur SaaS pour la base de données — le stockage ne coûte presque rien. Vous payez pour l'interface : les formulaires, les workflows, les permissions, les rapports — tout l'échafaudage qui permet à un humain d'opérer les données en sécurité.
Si un agent opère les données à sa place, une grande part de cet échafaudage devient optionnelle.
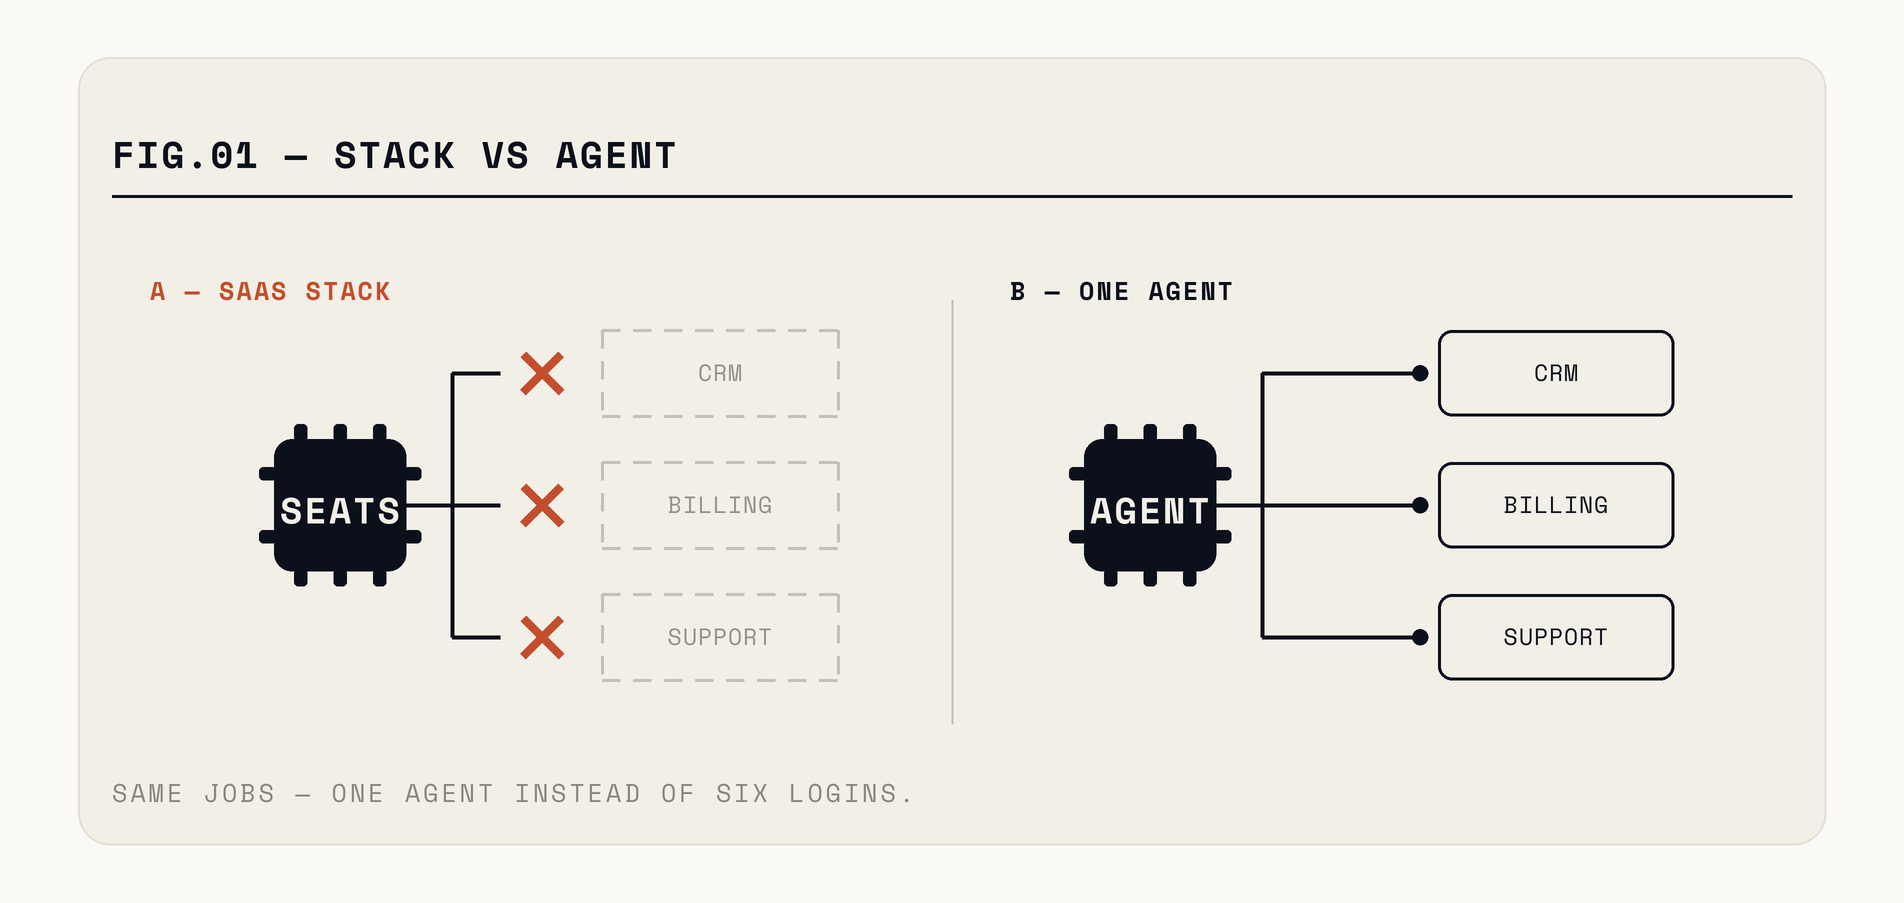
Fig. — La couche d'interface est ce que vous louez. Les agents changent qui l'utilise.
La prédiction qui n'arrive toujours pas
Tous les deux ou trois ans, quelqu'un annonce la fin du logiciel d'entreprise. Le low-code devait le faire. Puis les chatbots. Ni l'un ni l'autre ne l'a fait — et les raisons méritent d'être rappelées, parce qu'elles tiennent toujours.
Le logiciel n'est pas surtout des fonctionnalités. C'est surtout des décisions accumulées sur des cas limites — la règle fiscale d'un canton, le seuil d'approbation qui change en fin de trimestre, le client qui exige un autre format de facture. Un éditeur a passé une décennie à encoder tout cela. Un agent qui part d'un prompt vide, non.
La conformité est l'autre ancre. Les secteurs régulés n'ont pas seulement besoin de la bonne réponse ; ils ont besoin d'une trace défendable de la façon dont elle a été obtenue, produite par un système que quelqu'un a certifié. « Le modèle a décidé » n'est pas une piste d'audit.
Et les données vivent dans ces systèmes. Salesforce vaut cher en partie parce qu'en partir fait mal. Ce n'est pas un accident de conception.
Ce qui change, alors
La réponse honnête : les agents mangent l'interface, pas le système.
Regardez où les nombres de sièges tombent en premier. Les rôles qui existent surtout pour déplacer des données structurées entre systèmes — saisie de commandes, tri de premier niveau des tickets, imputation des notes de frais, hygiène du CRM — sont ceux où un agent fait réellement tout le travail au lieu d'y aider. Les éditeurs le savent — c'est pourquoi plusieurs sont déjà passés du prix au siège vers le prix à la consommation. Quand le logiciel fonctionne sans humain connecté, facturer par humain cesse d'avoir un sens.
Le deuxième glissement est plus discret et plus lourd. Si les agents sont les utilisateurs principaux, l'API devient le produit et l'interface devient une surface de revue. Les éditeurs qui traitaient leur API comme une arrière-pensée à contrecœur sont soudain exposés — un agent ne peut pas cliquer dans un écran sans équivalent programmatique.
Troisièmement, l'intégration cesse d'être de la plomberie et devient le vrai différenciateur. Un agent qui n'atteint qu'un seul système est un chatbot avec des étapes en plus. Sa valeur grandit avec le nombre d'outils qu'il peut appeler — la douve se déplace donc vers celui qui détient les connexions.
Le problème d'intégration que personne n'a résolu
Voici où la vision heurte un mur sans rapport avec la qualité du modèle.
Un agent qui opère à travers votre stack a besoin d'identifiants pour chaque système qu'il touche — et ces identifiants doivent être limités à ce qu'il a le droit de faire. La plupart des logiciels d'entreprise ont été bâtis sur l'hypothèse qu'un identifiant appartient à une personne qui a un manager, un ordinateur portable et une date de départ. L'identité non humaine — un agent avec ses propres permissions, sa propre piste d'audit et son propre chemin de révocation — est réellement immature chez la plupart des éditeurs.
Résultat pratique : les premiers déploiements font tourner les agents avec un compte de service détenant bien plus d'accès que la tâche n'exige — parce que c'est la seule façon de les faire marcher. C'est une posture de sécurité que personne ne défendrait si on posait la question directement. Et elle est aujourd'hui très répandue.
Le deuxième mur, c'est la gestion d'erreurs entre systèmes. Quand un humain rencontre un état inattendu dans un outil, il s'arrête et demande à quelqu'un. Quand un agent le rencontre à mi-chemin d'une séquence multi-systèmes, vous pouvez finir avec un bon de commande créé, un stock mis à jour — et une approbation qui n'a jamais été déclenchée : une transaction à moitié terminée sans propriétaire évident. Les gens des systèmes distribués connaissent ce problème depuis trente ans. La plupart des frameworks d'agents sont en train de le redécouvrir.
Où ça marche réellement aujourd'hui
Sautez les démos et regardez les déploiements qui ont survécu à la production.
Le support client est le plus avancé — mais pas comme on le vend d'habitude. Les victoires ne sont pas l'autonomie totale : ce sont des agents qui résolvent de bout en bout la poignée de types de tickets les plus répétitifs — remboursement ou changement d'adresse compris — et routent tout le reste vers une personne, contexte déjà rassemblé.
Les opérations financières sont l'autre cas. Rapprochement de factures, contrôles de politique de frais et réconciliation sont volumineux, riches en règles et ennuyeux — exactement le profil qui convient à un agent. Le mode d'échec est aussi contenu : une écriture fausse se rattrape à la revue, pas chez le client.
Les opérations commerciales sont entre les deux. Consigner les appels, mettre à jour les fiches, enrichir les contacts fonctionne bien. Décider ce que vaut une affaire, non — et les équipes qui brouillent cette ligne se brûlent.
Notez ce que ces cas partagent : un périmètre borné, des actions réversibles, et un humain qui peut inspecter la sortie avant qu'elle compte. Aucun n'est l'employé numérique pleinement autonome de la keynote. Ce sont des métiers étroits avec une définition claire du terminé — exactement pourquoi ils ont survécu au pilote. Les équipes aux plus grandes déceptions ont presque toujours commencé par de l'ouvert — « gère nos opérations » plutôt que « vide cette file précise » — et conclu que la technologie n'était pas prête, alors que le brief était le problème.
Quoi en faire, concrètement
Si vous achetez du logiciel, la question à court terme n'est pas de remplacer votre stack. C'est de savoir si vos éditeurs ont une API vers laquelle pointer un agent — et si votre contrat facture des sièges dont vous n'aurez peut-être plus besoin dans deux ans. Les deux méritent d'être soulevés au renouvellement, et les deux sont des questions inhabituelles dans la bouche d'un client — précisément pourquoi elles retiennent l'attention.
Si vous construisez du logiciel, la pression atterrit à un endroit moins confortable. Un produit dont la valeur est le confort de son interface est en position plus faible qu'avant. Un produit dont la valeur est une donnée propriétaire, un réseau d'intégrations durement gagné ou une vraie logique métier est en position plus forte. Être honnête sur lequel des deux vous êtes sert plus que de glisser un assistant dans la barre latérale.
Il y a un troisième groupe à nommer : les équipes qui passeront 2026 à construire des agents internes sur du logiciel qu'elles paient déjà. C'est là qu'atterrit l'essentiel de la vraie valeur cette année — et ça n'exige d'aucun éditeur qu'il change quoi que ce soit. Le prérequis est sans gloire : des données de référence propres, des API documentées, et quelqu'un prêt à posséder ce que l'agent a le droit de faire.
La stack ne disparaît pas. L'hypothèse qu'une personne est assise devant toute la journée — voilà la partie qui ne tient plus. Et la plupart des logiciels ont été conçus entièrement autour de cette hypothèse.
Décider lequel de vos systèmes mérite un opérateur et lequel mérite un agent, c'est le premier atelier de chaque projet d'agents que nous menons — apportez-nous la liste de votre stack.