


Conseil DevOps et services cloud sur AWS, DigitalOcean et Kubernetes.
Déploiements automatisés, surveillance et sécurité, pour que les mises en production deviennent une routine.
Contenu revu en
Ce que couvre une mission de conseil DevOps
Nous reprenons un système en production par petites étapes réversibles : d'abord les builds et déploiements automatisés, puis la supervision et les alertes, puis la sécurité et les sauvegardes. Les mises en production deviennent une routine, plus une nuit blanche. Nous exploitons FeelEat sur DigitalOcean avec Kubernetes et Docker, et LeadTrack AI sur AWS avec Docker.
On ne remarque l'infrastructure que lorsqu'elle lâche — au pic de trafic, pendant la démo, à 3 h du matin. Les causes ne sont jamais exotiques : des serveurs modifiés à la main, des déploiements qui dépendent d'une seule personne, des alertes que personne ne lit et des coûts dont personne ne répond.
Nous la rendons ennuyeuse à dessein. Tout en code, chaque déploiement automatisé et réversible, chaque système observable avant de dérailler. Nous avons construit tout le DevOps de FeelEat sur DigitalOcean, avec Kubernetes et Docker, et celui de LeadTrack AI sur AWS, avec Docker.
Conçu pour le calme.
Les six couches d'un cloud de production qui laisse tout le monde dormir.
Architecture cloud
Des environnements multiples sur AWS ou DigitalOcean, bien dimensionnés, pensés pour la charge que vous avez réellement.
CI / CD
Des pipelines qui testent, construisent et livrent à chaque merge — avec déploiements progressifs et rollback en un clic.
Sécurité & supervision
IAM au moindre privilège, gestion des secrets, pistes d'audit et alertes réglées pour ne réveiller des humains que quand un humain peut aider.
Infrastructure as Code
Terraform pour chaque ressource — relisible, reproductible, et reconstructible de zéro en un après-midi.
Auto-scaling & maîtrise des coûts
Une capacité qui suit la demande et des budgets avec des responsables — la performance et la facture sous contrôle.
Réponse aux incidents
Runbooks, alertes automatiques 24 h/24 et post-mortems sans blâme — avec une astreinte disponible dans un retainer DevOps managé.
Stabiliser, automatiser, oublier.
Nous reprenons des systèmes en production par petites étapes réversibles — vos utilisateurs ne remarquent jamais le changement de mains.
01Auditer & cartographier
Chaque ressource, dépendance et point de défaillance unique documenté — y compris ceux que seul un ingénieur connaissait.
02Codifier la vérité
L'infrastructure existante importée dans Terraform. Dès lors, chaque changement passe par une pull request relue plutôt que par une session SSH.
03Automatiser la livraison
CI/CD avec tests, staging et rollback. Les déploiements passent d'événements redoutés à des non-événements, quotidiens.
04Observer & durcir
Tableaux de bord, alertes, tests de charge et revue de sécurité — puis, en option, l'exploitation continue par la même équipe.
Votre produit pourrait être le prochain cas sur cette page.
Commencer par un atelier gratuit de 4 heuresKubernetes sous une activité food-tech.
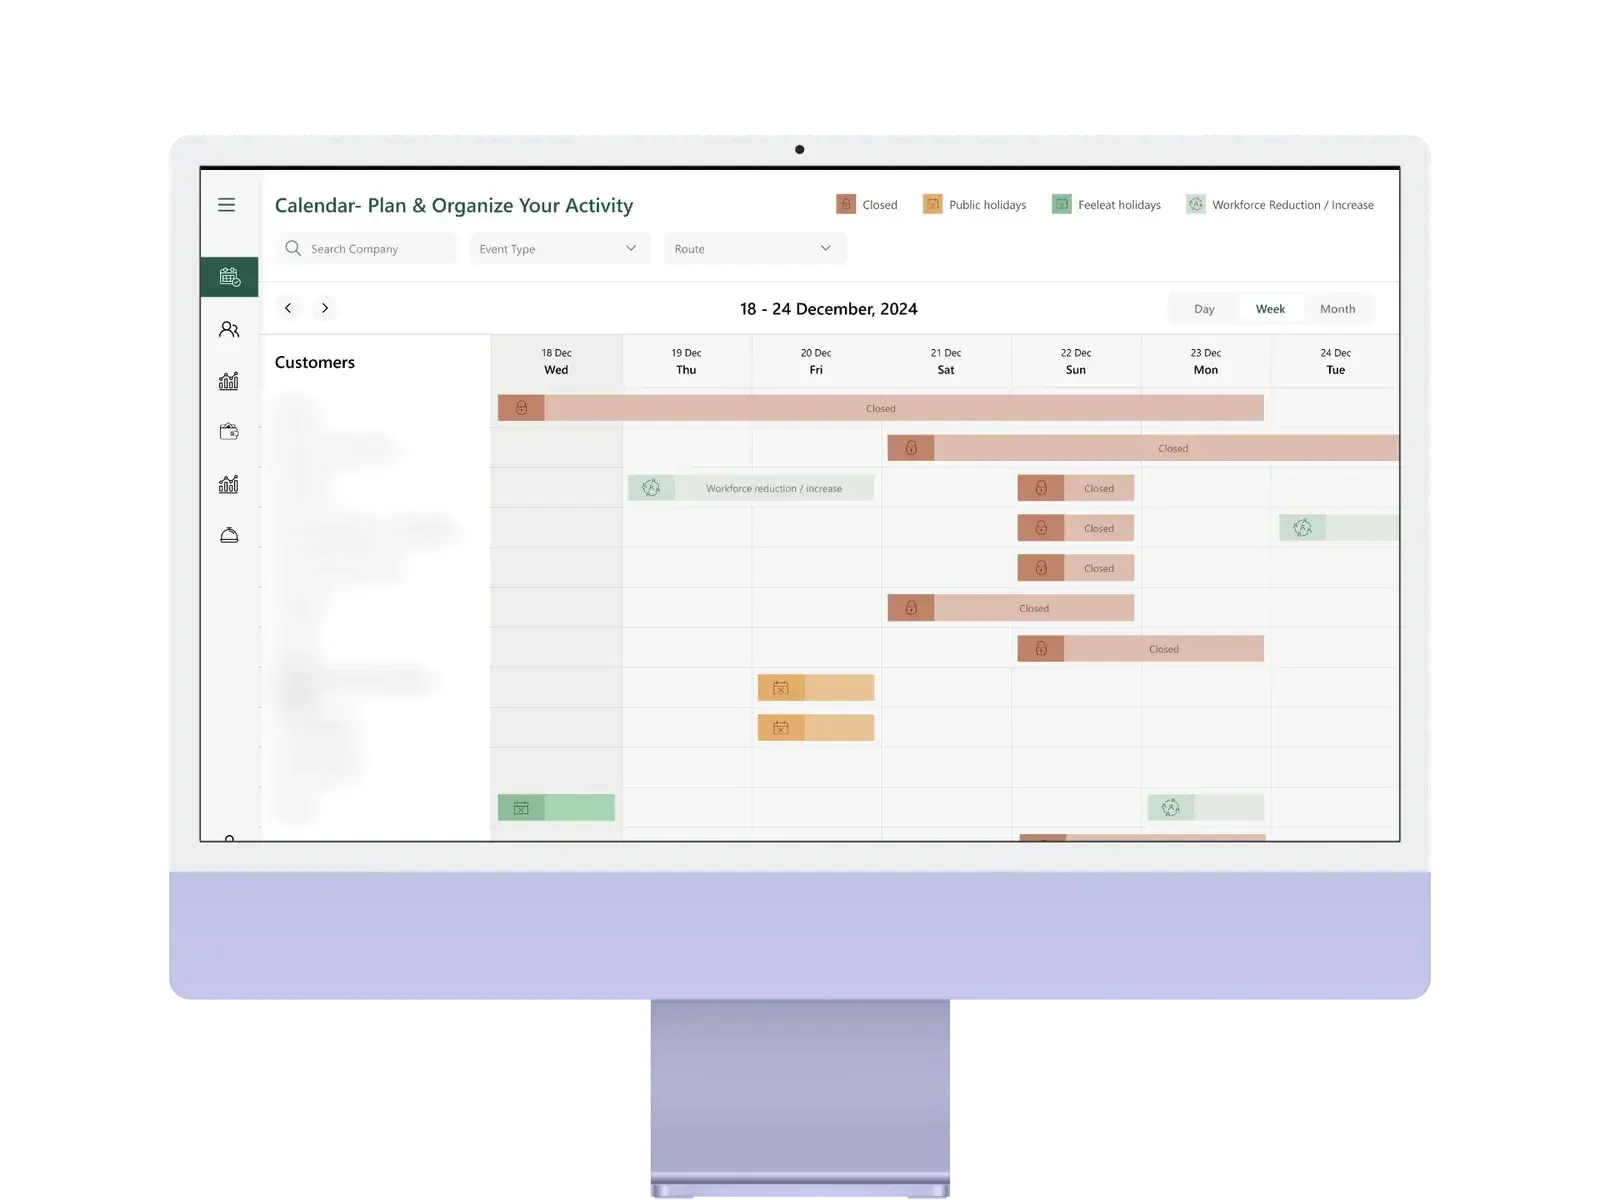
Tout le DevOps derrière les logiciels de FeelEat, sur DigitalOcean. Pour LeadTrack AI, nous avons fait de même sur AWS.
FeelEat
Nous avons construit le DevOps de FeelEat sur DigitalOcean : des services emballés dans des conteneurs Docker et exécutés sur Kubernetes. LeadTrack AI tourne sur AWS, aussi avec Docker, et son DevOps vient de la même équipe.
Terraform et compagnie.
AWS ou DigitalOcean, Docker et Kubernetes, avec tout automatisé : la chaîne d'outils que votre prochaine recrue connaît déjà.
Ce qui tourne sur ces fondations.
La plupart de nos missions d'infrastructure existent pour porter l'un de ces produits.
Les réponses de ceux qui tiennent la garde.
Reprises, factures, Kubernetes, conformité — réponses directes des ingénieurs qui veillent sur ces systèmes.
Décrivez-le dans un brief. Un ingénieur senior le lit et répond sous un jour ouvré.
Pouvez-vous reprendre une infrastructure que nous exploitons déjà ?
Oui — c'est la mission la plus courante. Nous auditons, importons tout dans Terraform et stabilisons avant de changer quoi que ce soit. Pas de migration big-bang : votre disponibilité n'est jamais l'enjeu du pari.
Cela va-t-il réduire notre facture cloud ?
Souvent, grâce au bon dimensionnement, à la planification et au nettoyage du stockage, mais nous ne donnons un chiffre qu'après l'audit. Surtout, les coûts deviennent visibles et attribués : la facture cesse d'être une surprise mensuelle.
Avons-nous encore besoin de notre propre recrue DevOps ?
Pas nécessairement. Nous pouvons exploiter le système pour vous, ou bâtir la plateforme puis former votre propre recrue dessus. Dans les deux cas, le code et les comptes cloud vous appartiennent : vous n'êtes lié à rien.
Comment gérez-vous la conformité — RGPD, SOC 2, ISO ?
L'infrastructure en code fait des preuves de conformité un sous-produit : pistes d'audit, revues d'accès et rapports générés automatiquement.
Avons-nous besoin de Kubernetes ?
Probablement pas. La plupart des équipes de moins de 50 ingénieurs sont mieux servies par un PaaS managé (Vercel, Fly, Railway, ECS, Cloud Run). Nous adoptons Kubernetes quand sa complexité opérationnelle est justifiée par une véritable échelle ou des exigences de conformité.
Et la reprise après sinistre ?
Nous concevons les objectifs RTO/RPO pour correspondre à ce dont le métier a réellement besoin, implémentons des sauvegardes automatisées avec procédures de restauration testées, et pouvons mener des exercices de restauration réguliers quand vos règles de conformité l'exigent.
À quoi ressemble réellement une bonne observabilité ?
Les trois piliers faits délibérément : logs structurés, métriques et traces distribuées corrélés par un ID de requête, avec OpenTelemetry comme couche d'instrumentation pour ne pas être verrouillé à un seul fournisseur. Le test : un ingénieur d'astreinte peut-il passer d'une alerte à la cause racine en minutes sans SSH sur une machine. Un tableau de bord que personne n'ouvre ne compte pas.
Comment rendez-vous les déploiements assez sûrs pour les faire plusieurs fois par jour ?
Développement trunk-based, tests automatisés comme porte de merge, et livraison progressive — canary ou blue-green avec rollback automatique sur régression de taux d'erreur ou de latence. Les feature flags découplent le déploiement de la release pour que livrer du code et l'activer soient des décisions séparées. De fréquents petits déploiements sont plus sûrs que de rares gros, ce qui est l'opposé de l'intuition de la plupart des équipes.
À quand remonte un déploiement
sans retenir votre souffle ?
Parlez-nous de votre stack, de vos jours de déploiement et de votre dernier incident. Un ingénieur infrastructure senior répond sous un jour ouvré avec ce que nous stabiliserions en premier.