Un chiffre, une seule source de vérité.
Pipelines, entrepôts et BI qui transforment des événements bruts en décisions — pour que finance, ops et direction cessent de débattre de quel tableur a raison.
Contenu revu en
Un entrepôt plein de peut-être.
La plupart des entreprises n'ont pas un problème de données — elles ont un problème de confiance. Les chiffres vivent dans six outils, trois exports et le laptop d'un analyste héroïque. Chaque réunion commence par un débat sur le chiffre juste, et chaque décision prend une semaine de retard à cause de ça.
Nous construisons la couche porteuse, ennuyeuse, qui règle ça : des pipelines qui n'échouent pas en silence, des entrepôts modélisés sur le fonctionnement réel de votre activité, et des tableaux de bord consultés avant le premier café. Gouvernance et contrôle d'accès inclus — les bonnes personnes voient les bons chiffres, et les auditeurs cessent de vous faire transpirer.
Des événements bruts aux décisions.
Le chemin complet, de l'ingestion à l'insight, conçu comme un seul système avec un seul responsable.
Pipelines de données & ELT
Une ingestion fiable depuis vos apps, outils SaaS et appareils — orchestrée, testée, et qui alerte avant que vous ne remarquiez quoi que ce soit.
Entrepôt & modélisation
Un entrepôt modélisé sur vos entités métier, avec des transformations façon dbt que votre équipe peut lire et étendre.
BI & tableaux de bord
Des tableaux de bord Power BI, Metabase ou Superset construits pour les questions qu'on pose vraiment chaque lundi.
Reporting prédictif
Prévisions et détection d'anomalies posées sur des données propres et gouvernées — la rampe d'accès vers du ML sérieux.
Automatisation & reverse ETL
Des données propres repoussées dans votre CRM et vos outils d'ops, pour que l'insight devienne action automatiquement.
Gouvernance & conformité
Contrôle d'accès, lignage et politiques de rétention — conformes RGPD par défaut, prêts pour l'audit par conception.
La confiance se construit par incréments.
Nous gagnons l'adoption un chiffre fiable à la fois, en commençant là où la douleur est la plus vive.
01Cartographier les questions
Nous partons des dix décisions que votre équipe prend chaque semaine, puis remontons vers les données nécessaires.
02Une métrique en or
Le premier sprint livre un seul chiffre automatisé, souvent le revenu ou les stocks, que chacun peut vérifier à la source. Chaque sprint suivant ajoute la métrique d'après.
03Modéliser & documenter
Entités, définitions et lignage couchés par écrit, pour que « client actif » signifie une seule chose, partout, pour toujours.
04Exploiter & étendre
Supervision, alertes et une équipe senior d'astreinte. Les nouvelles questions deviennent de nouveaux modèles — sur la même fondation.
Votre produit pourrait être le prochain cas sur cette page.
Commencer par un atelier gratuit de 4 heuresLa tuyauterie sous la prévision.
La prévision ne fonctionne que si la couche de données en dessous est fiable. Cette plateforme est les deux — et nous avons construit chaque moitié.
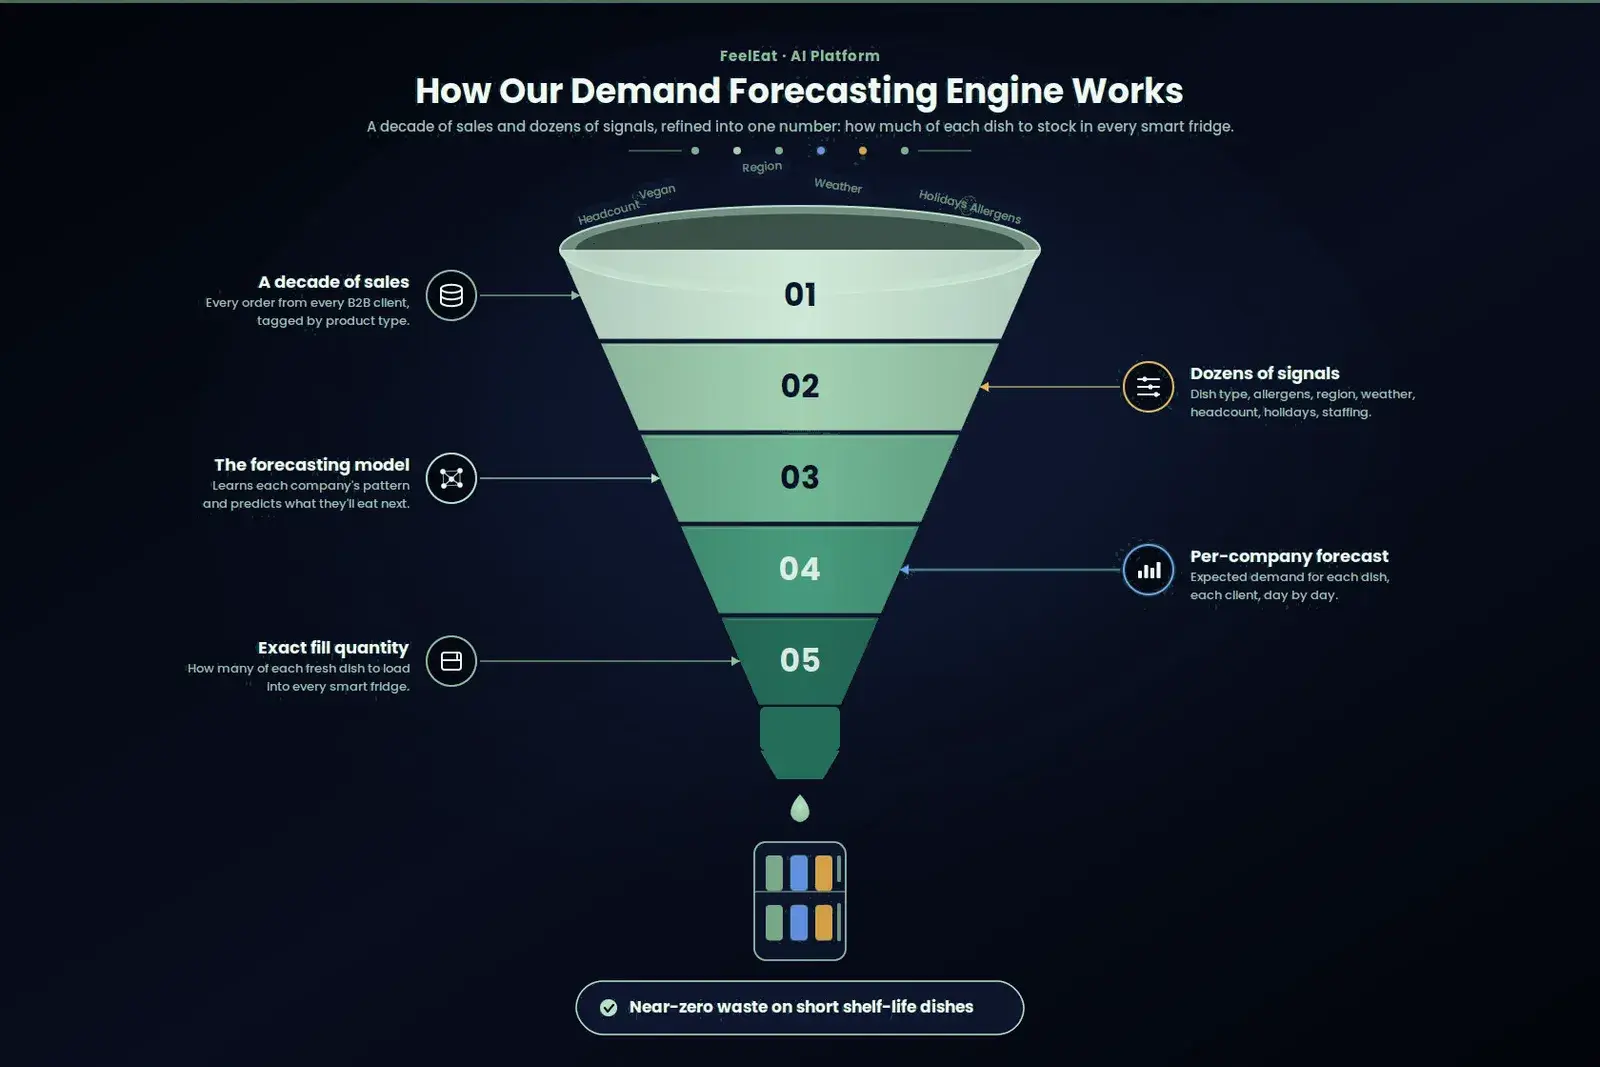
01Chaque commande B2B en entrée, classée par type de produit
Forecasting Model
Ventes en direct, saisonnalité et signaux opérationnels traversent des pipelines conçus par nos soins vers une plateforme de prévision avec laquelle les équipes planifient vraiment — stocks, effectifs et dépenses.
Des choix faits pour rester.
dbt, Airflow et Postgres : votre équipe hérite de ces choix, alors nous les faisons avec prudence.
Où vont les données ensuite.
Des chiffres propres sont rarement la fin de l'histoire. Voici ce qui se construit généralement après.
Par où commencent la plupart des projets data.
S'il vous faut vraiment un entrepôt, ce que deviennent les coûts, et qui maintient l'ensemble après nous.
Décrivez-le dans un brief. Un ingénieur senior le lit et répond sous un jour ouvré.
Nos données sont un chaos. Par où commencer ?
Comme partout. Nous commençons par un audit de deux semaines : ce qui existe, où ça vit, ce qui est fiable. Vous obtenez une carte priorisée et une proposition à prix fixe pour la première métrique en or — sans refonte de plateforme préalable.
Faut-il un entrepôt de données, ou Postgres suffit-il ?
Souvent, Postgres suffit largement — et nous vous le dirons. Les entrepôts dédiés justifient leur coût à grande échelle ou sous forte charge analytique. Nous dimensionnons l'architecture sur les données que vous avez réellement, rien de plus.
Pouvez-vous travailler avec notre outil de BI existant ?
Oui. Power BI, Metabase, Superset, Looker — l'outil compte moins que la modélisation en dessous. Nous réparons d'abord la fondation, puis ce qui est posé dessus affiche enfin des chiffres cohérents.
Comment gérez-vous le RGPD et la résidence des données ?
Hébergement en zone UE sur demande, minimisation des données personnelles dès la conception des pipelines, accès par rôle à chaque couche et lignage documenté. Nous concevons tout cela au niveau du schéma, pour qu'un audit le trouve déjà en place.
Comment empêchez-vous les tableaux de bord de se contredire ?
La cause habituelle est que chacun définit « utilisateur actif » ou « revenu » légèrement différemment dans ses propres requêtes. Nous corrigeons cela avec une couche sémantique unique modélisée dans dbt, où chaque métrique est définie une fois puis réutilisée partout, pour que le même chiffre apparaisse dans Metabase, dans l'outil de vente et dans la présentation au board.
Comment empêchez-vous les coûts d'entrepôt de s'envoler ?
Les coûts explosent à cause des scans de tables complètes, des modèles reconstruits de zéro à chaque exécution, et des tableaux de bord martelant les tables brutes. Nous utilisons des modèles incrémentaux, partitionnons et clusterisons les grandes tables, matérialisons les agrégations lourdes et configurons l'auto-suspend de l'entrepôt. Snowflake et BigQuery facturent tous deux sur le compute scanné, donc les économies viennent de scanner moins — généralement 30–50% post-audit.
Quand le streaming temps réel vaut-il la complexité face au batch ?
Rarement, honnêtement. Le batch toutes les quelques minutes couvre la plupart des besoins analytiques à une fraction du coût opérationnel. Le temps réel (Kafka, Materialize, ClickHouse) gagne sa place pour le scoring de fraude, les tableaux de bord live-ops et les enchères publicitaires — où une décision en secondes a une vraie valeur. Nous repousserons si le « temps réel » est une envie plutôt qu'un besoin mesurable.
Mon équipe pourra-t-elle le maintenir ?
Oui. Chaque pipeline est livré avec documentation, runbooks et un transfert en pairing d'une semaine. Nous pouvons rester en retainer pour l'évolution, ou rendre entièrement et sortir gracieusement.
Fatigué de débattre du
chiffre juste ?
Dites-nous quelles décisions attendent encore leurs données. Vous recevez le retour d'un ingénieur data senior sous un jour ouvré — par où nous commencerions.